Packages
Background
見つけた論文のシミュレーションを再現してみようシリーズ。今回は Nordstokke & Zumbo (2007) です。論文の主張はDiscussionで以下の4点にまとめられています。
- 「Levene検定」は一体どの計算式を使ったLevene検定なのか明確にすべき。統計ソフトで広く実装されているのは、オリジナルである平均値からの偏差の絶対値を利用しているものである。
- 等分散性のためのF検定ほどではないが、オリジナルのLevene検定のType I error rateはインフレする。そしてその程度は分布の歪度とサンプルサイズ比次第である。
- Levene検定もF検定も名目上の\(\alpha\)を維持できる条件(=分布が対称のとき)では、F検定の方が検出力が高い。
- (≒より性能が良いとして先発の方法を代替したはず後発の方法が、先発の方法よりもダメじゃん的な意を言いたいはず。)
- 現状の知見では、中央値ベースのLevene検定(つまりBrown-Forsythe検定)の利用を推奨するが、実装している統計ソフトが少ない。簡便に計算できる「ノンパラメトリックLevene検定」ならType I error rateを維持できる。
- データをプールして得点を順位に変換する。
- 各データをもとのグループに戻す。
- 平均値ベースのLevene検定(=オリジナル)を行う。
上記の論点のうち2と3がシミュレーションによって示されています(4のノンパラ版についてはDiscussionでいきなり出てきた)。今回はそれを再現してみようと思います。なお、元論文ではSPSSを使ってシミュレーションをしたと書いてあります。ネットで検索してみたら、どうやらモンテカルロシミュレーションを行える機能があるようです。SPSSには触れる機会があるので、今度ちょっと試してみたいです。
“Levene test”
前の投稿1ではちゃんと書きませんでしたが改めて確認します。SPSSでt検定を行うと結果の出力についてくる「等分散性のためのLevene検定」のLevene検定ですが、「Levene検定」という名称では複数の方法を指していることになると Nordstokke & Zumbo (2007) は主張しています。 まず、オリジナルのLevene検定2は、もとの観測値\(X_{ij}\)について以下のような変換を行います。 \[ Z_{ij}=|X_{ij}-\bar{X_j}| \] なお\(X_{ij}\)は\(j\)番目の群の\(i\)番目の観測値、\(\bar{X_j}\)は\(j\)番目の群の平均値を表します。つまり、「個々の観測値からその観測値が属する群の平均値を引いたものの絶対値」を計算しているわけです。この\(Z_{ij}\)を使って一元配置分散分析を行うのがオリジナルのLevene検定です。 Nordstokke & Zumbo (2007) では(T2)、 Brown & Forsythe (1974) では 統計量\(W_0\)と書かれています。 これに対して、群の平均値の代わりに群の中央値を用いるものもあります。つまり、 \[ Z_{ij}=|X_{ij}-{Mdn}_j| \] とするものです。 この変換による方法は Nordstokke & Zumbo (2007) では(T3)、 Brown & Forsythe (1974) では統計量\(W_{50}\)と書かれています。 Brown & Forsythe (1974) が提案したので一般的にはBrown-Forsythe検定と呼ばれていると思います(し私もそう呼んでいます)が、計算式自体はLevene検定とほぼ変わらないため、「中央値ベースのLevene検定」という言い方もできます。そうなると、オリジナルは「平均値ベースの…」と言えますね。 なお、 Brown & Forsythe (1974) は、さらに群の平均値を群の10%トリム平均値に置き換えるもの(論文中では\(W_{10}\)と表記されている)も提案しています。 まとめると、これらの検定(“Levene-style test”と言えるでしょうか)は、観測値に対して\(Z_{ij}=|X_{ij}-C_j|\)(\(C_j\)は群\(j\)の中心を表す何かしらの統計量)という変換を行っているわけです。
そして、元論文が問題にしているのは、(当時の)社会科学系の教科書や統計ソフトのdocumentationに書かれているLevene検定が、いったいどの計算式について言及しているのかということです3。教科書やソフトでは「F検定よりも非正規性に頑健である」としてLevene検定が使われていますが、その書き方だと単に「Levene検定」と言うだけではどの中心指標(平均値or中央値orその他)を使った計算なのかがわからないので明記すべきだし、そもそもオリジナルは非対称な分布に脆弱だということはかなり前から指摘されているがそれがいまだに反映されていない、ということのようです。というわけで、F検定を代替しているオリジナルのLevene検定が実際どの程度非対称な分布に対して脆弱なのかを改めて示し、慣例に対して注意を促すというのが元論文の目的でした。
Simulation Design
シミュレーションにおけるデータ発生条件は以下の通りです。
- 母集団分布の歪度:4パターン
- 0, 1, 2, 3
- カイ二乗分布を使っていました。自由度が小さいときに右に歪み、自由度が大きいときは正規分布に近づく性質を利用したようです。あとでまた確認します。
- 0, 1, 2, 3
- 総サンプルサイズ:3パターン
- 24, 48, 96
- サンプルサイズ比:3パターン
- \(n_1/n_2=1/1,2/1,3/1\)
- 母分散比:9パターン
- \(\sigma^2_1/\sigma^2_1 = 5/1, 4/1, 3/1, 2/1, 1/1, 1/2, 1/3, 1/4, 1/5\)
- \(\sigma^2_1/\sigma^2_1 = 1/1\)の条件におけるERRがType I error rate、それ以外がpower。
- \(\sigma^2_1/\sigma^2_1 = 5/1, 4/1, 3/1, 2/1, 1/1, 1/2, 1/3, 1/4, 1/5\)
以上の計\(4\times3\times3\times9=324\)パターンを各5000回反復し、有意水準\(\alpha=.05\)でLevene検定とF検定の経験的な棄却率を求めていました。シミュレーションのコードはSimDesignパッケージのwiki4に例として挙げられているので、簡単にやるならそれをそのまま動かせばよいのですが、あえてここは人力で頑張ります(というか、RfastとかmatrixTestsみたいに、データ行列をそのまま入れて検定する方が多分速い(?)ので、それでできる限りはSimDesignを使わないでやってみたいというわがままです。正直言ってSimDesignでシミュレーション回す方がはるかに楽です)。
今回のプラスαをどうするかですが、総サンプルサイズと比較する検定を以下のようにしたいと思います。
- 検定:2種⇒4種
- 【追加】BF検定、元論文のDiscussionで提案されていたnon-parametric Levene検定(以下、np-Levene検定とします。)
- 前者は前回の記事でも使った
matrixTests::col_brownforsythe()で、後者はデータを順位変換するだけでいいので簡単に追加できます。
- 前者は前回の記事でも使った
- 【追加】BF検定、元論文のDiscussionで提案されていたnon-parametric Levene検定(以下、np-Levene検定とします。)
- 総サンプルサイズ:3パターン⇒9パターン
- 前の投稿で\(n_{total}=200\)までやっているので、24の倍数で200に近い192まで増分24と、極小サンプルサイズとして12を追加します。
- 12, 24, 48, 72, 96, 120, 144, 168, 192
- 前の投稿で\(n_{total}=200\)までやっているので、24の倍数で200に近い192まで増分24と、極小サンプルサイズとして12を追加します。
反復回数はさすがに1条件当たり5000回だと少ないので、10万回にします。
Preparation
Data generation
元論文では歪んだ分布からのデータ発生のためにカイ二乗分布を用いていましたが、自由度の選定については以下のように書かれていました(Nordstokke & Zumbo, 2007, p. 6)。
It should be noted that the population skewness was determined empirically for large sample sizes of 100,000 simulees with 10,000, 7.4, 2.2, and 0.83 degrees of freedom resulting in skewness values of 0.03, 1.03, 1.92 , and 3.06, respectively.
単発で乱数計算をしたように見受けられますがどうなんでしょうか?とりあえず再現してみるならこんな感じでしょうか。
c(1e5L, 7.4, 2.2, 0.83) |>
  setNames(nm = paste0("ex_skew_", 0:3)) |>
  sapply(
    FUN = \(x) {
      rchisq(1e5L, df = x) |>
1        e1071::skewness(type = 2)
    }
)- 1
-
あとで使う
Rfast::colskewness()の値と一緒になるのがtype = 2でした。HelpにはSASとSPSSがこのタイプの計算式で実装されていると書いてありました。
    ex_skew_0     ex_skew_1     ex_skew_2     ex_skew_3
-0.0005998212 1.0241163983 1.9096444319 2.9700363571 シードを固定していないので、大体同じ数値になったり微妙に外れたり…。1回だけでは何とも言えないので複数回繰り返してみます。意外とrchisq(n = 1e5L, ...)×4回が重くて反復に時間がかかります5。
Code
set.seed(2026)
temp_n_iter <- 100L
temp_mat <- matrix(
  NA_real_,
  nrow = temp_n_iter,
  ncol = 4,
  dimnames = list(
    NULL,
    paste0("ex_skew_", 0:3)
  )
)

for(temp_i in seq_len(temp_n_iter)) {
    temp_mat[temp_i, ] <- cbind(
      rchisq(1e5L, df = 1e4L),
      rchisq(1e5L, df = 7.4),
      rchisq(1e5L, df = 2.2),
      rchisq(1e5L, df = 0.83)
    ) |>
      Rfast::colskewness()
  }

temp_mat |>
  apply(
    MARGIN = 2,
    FUN = \(x) c(summary(x), SD = sd(x))
  ) |>
  round(digits = 4)
ex_skew_0 ex_skew_1 ex_skew_2 ex_skew_3
Min. 0.0113 1.0072 1.8372 2.9816
1st Qu. 0.0208 1.0310 1.8901 3.0629
Median 0.0269 1.0412 1.9073 3.1010
Mean 0.0266 1.0408 1.9049 3.0997
3rd Qu. 0.0321 1.0504 1.9220 3.1351
Max. 0.0460 1.0679 1.9546 3.2144
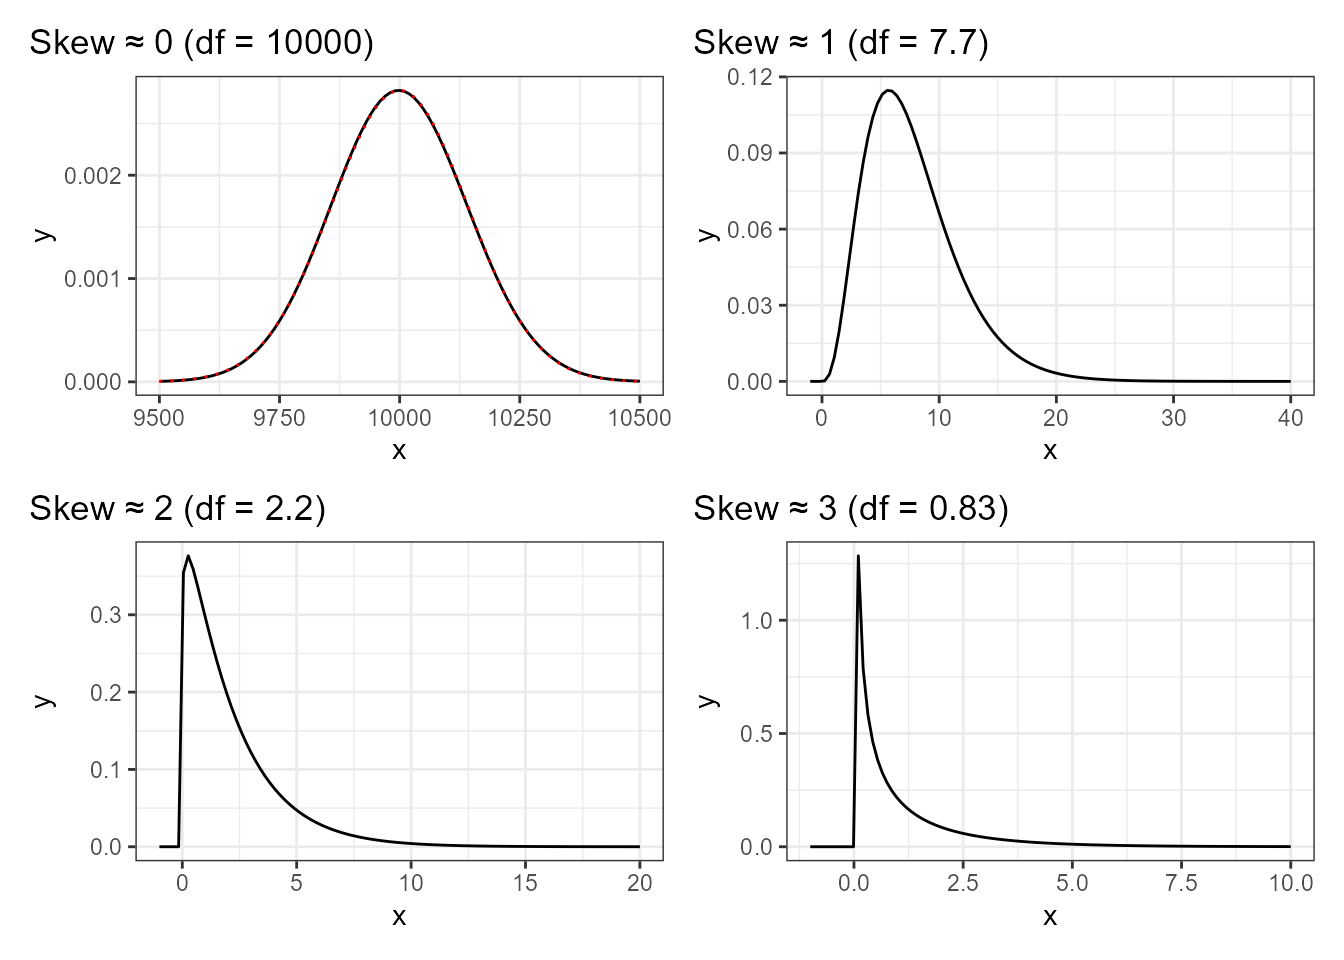
SD 0.0078 0.0135 0.0248 0.0500小数第2位レベルで若干違いますね。100回しか反復していないので多少は誤差もあると思います。小数第一位を四捨五入すれば0, 1, 2, 3なのでまあ良しとします。なお、wikipediaのカイ二乗分布のページ6によると、カイ二乗分布の歪度は自由度を\(k\)とすると\(2\sqrt{2}/k\)で求まるとのことなので、歪度0ならdf = めっちゃ大きい数字、1ならdf = sqrt(8)、2ならdf = sqrt(2)、3ならdf = sqrt(8)/3とするのがいいと思うのですが、シミュレーションの再現ということで今回は論文の通りに行きます。
分布の形はこんな感じです(縦横のスケールがそろってないのは許してください。)。\(Skew \approx 0\)については、正規分布\(N(10000, 2\times10000)\)を重ねていますが、ピッタリですね。
Code
list(
  ggplot() +
    geom_function(
      fun = dchisq,
      args = list(df = 10000),
      xlim = c(9500, 10500)
    ) +
    geom_function(
      fun = dnorm,
      args = list(
        mean = 10000,
        sd = sqrt(2 * 10000)
      ),
      color = "red",
      linetype = "dotted",
      xlim = c(9500, 10500)
    ) +
    labs(title = "Skew \u2248 0 (df = 10000)"),
  ggplot() +
    geom_function(
      fun = dchisq,
      args = list(df = 7.7),
      xlim = c(-1, 40)
    ) +
    labs(title = "Skew \u2248 1 (df = 7.7)"),
  ggplot() +
    geom_function(
      fun = dchisq,
      args = list(df = 2.2),
      xlim = c(-1, 20)
    ) +
    labs(title = "Skew \u2248 2 (df = 2.2)"),
  ggplot() +
    geom_function(
      fun = dchisq,
      args = list(df = 0.83),
      xlim = c(-1, 10)
    )+
    labs(title = "Skew \u2248 3 (df = 0.83)")
) |>
  patchwork::wrap_plots() &
  theme_bw() &
  theme(
    plot.title.position = "plot"
  )
Analyse function
これも前と同じで、乱数データを行列で入れて処理します。np-Levene検定は元データをプールして順位変換するのですが、処理はRfast::colRanks()を利用すれば手早く済みます。
f_analyse <- function(mat, g) {
  ftest <- Rfast::var2tests(
    x = mat,
    ina = g
  ) |>
    _[, "pvalue"]
  levene <- matrixTests::col_levene(
    x = mat,
    g = g
  ) |>
    _$pvalue
  bf <- matrixTests::col_brownforsythe(
    x = mat,
    g = g
  ) |>
    _$pvalue
  nplevene <- Rfast::colRanks(mat) |>
    matrixTests::col_levene(g = g) |>
    _$pvalue
  cbind(ftest = ftest, levene = levene, bf = bf, nplevene = nplevene)
}

# check
matrix(
  rnorm(192 * 5),
  ncol = 5
) |>
  f_analyse(g = rep(factor(1:2), times = c(96, 96)))
ftest levene bf nplevene
[1,] 0.63519603 0.56805536 0.61580131 0.73716532
[2,] 0.58310133 0.67200989 0.66527775 0.20235356
[3,] 0.19011669 0.27284325 0.27225706 0.41201984
[4,] 0.08025385 0.03156759 0.02970896 0.02227503
[5,] 0.61162386 0.64831904 0.67951933 0.82396661OKですね。バッチ処理用の関数も作ります。今回はp値をそのまま返してもらいます。前はreplicate()で乱数データ行列を生成していたのですが、AIに聞いたりベンチマークを回したりしたら、直接matrix()で作って後から当該群の数値だけいじるってのが速いし実質同じやでと教えてもらったので、その方法を採用しました。
f_analyse_batch <- function(
    n_sim,
    df_chisq,
    n_total,
    var_ratio,
    vec_group
) {
  # index
  x_g1 <- vec_group == 1
  # data generation
1  temp_mat <- matrix(
    rchisq(
      n = n_total * n_sim,
      df = df_chisq
    ),
    nrow = n_total,
    ncol = n_sim
  )
  temp_mat[x_g1,] <- temp_mat[x_g1,] * sqrt(var_ratio)
  # analysis
  f_analyse(temp_mat, g = vec_group)
}

# check
bench::system_time(
  f_analyse_batch(
    n_sim = 1000,
    df_chisq = .83,
    n_total = 192,
    var_ratio = 1,
    vec_group = rep(factor(1:2), times = c(96, 96))
  ) |>
    head() |>
    print()
)- 1
-
今回は2群ともカイ二乗分布の自由度は揃えているので、初めに一気に
rchisq()で乱数を生成してあとからいじりたい方だけいじるのでもやりたいことはできてる、とコパイロットに教えてもらいました。
            ftest     levene        bf  nplevene
[1,] 1.074190e-01 0.54520070 0.5191349 0.1996881
[2,] 5.113889e-01 0.68827225 0.9210745 0.3921441
[3,] 3.397601e-07 0.09280991 0.2536626 0.9857501
[4,] 6.246915e-03 0.14036059 0.2948814 0.4710293
[5,] 4.396466e-03 0.17233964 0.1372423 0.2047743
[6,] 1.046933e-01 0.72892704 0.7424855 0.4985640
process    real
 62.5ms  62.2ms
OKですね。
Simulation
Set up
シミュレーション条件は以下の通りです。
# A tibble: 972 × 4
   idx_skew n_total n_ratio var_ratio
      <int>   <int>   <int> <fct>
 1        0      12       1 5/1
 2        0      12       1 4/1
 3        0      12       1 3/1
 4        0      12       1 2/1
 5        0      12       1 1/1
 6        0      12       1 1/2
 7        0      12       1 1/3
 8        0      12       1 1/4
 9        0      12       1 1/5
10        0      12       2 5/1
# ℹ 962 more rows
972条件になりました。群分け用のベクトルも先に作ります。
list_vec_group <- df_design |>
  distinct(n_total, n_ratio) |>
  dplyr::mutate(
    name_cond = str_c(n_total, n_ratio, sep = "_"),
    res = pmap(
      .l = list(
        x = n_total,
        y = n_ratio
      ),
      .f = \(x, y) {
        n_g1 <- x * y  / (y + 1)
        n_g2 <- x - n_g1
        factor(1:2) |>
          rep(times = c(n_g1, n_g2))
      }
    ) |>
      set_names(nm = name_cond)
  ) |>
  pull(res)

# check
head(list_vec_group)
$`12_1`
[1] 1 1 1 1 1 1 2 2 2 2 2 2
Levels: 1 2
$`12_2`
[1] 1 1 1 1 1 1 1 1 2 2 2 2
Levels: 1 2
$`12_3`
[1] 1 1 1 1 1 1 1 1 1 2 2 2
Levels: 1 2
$`24_1`
[1] 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2 2
Levels: 1 2
$`24_2`
[1] 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2
Levels: 1 2
$`24_3`
[1] 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2
Levels: 1 2今回は歪度と母分散比を人が見やすいようにしたので、これらが分析用の関数の引数に合うようにオブジェクトを作ります。
      0       1       2       3
1.0e+04 7.4e+00 2.2e+00 8.3e-01 5/1 4/1 3/1 2/1 1/1 1/2 1/3 1/4 1/5
5.0000000 4.0000000 3.0000000 2.0000000 1.0000000 0.5000000 0.3333333 0.2500000 0.2000000 反復数は1条件当たり10万回です。ブロックサイズは25000にします。
    n_iter block_size
 "100,000"  " 25,000"
プログレスバーを用意します。
Run simulation
いつものごとくあらかじめ実行してきました。
# seed
set.seed(20260917)

# multisession & check
future::plan(
  future::multisession,
  workers = parallelly::availableCores() -1
)
future::nbrOfWorkers()

progressr::with_progress({
  # progress bar setup
1  pb <- progressr::progressor(steps = nrow(df_design) * (int_n_iter / int_n_block_size))
  # simulation
  res_raw_df <- df_design |>
    expand_grid(batch_id = seq_len(int_n_iter / int_n_block_size)) |>
    mutate(n_sim = int_n_block_size) |>
    mutate(
      temp_p = furrr::future_pmap(
        .l = list(
          idx_skew,
          n_total,
          n_ratio,
          var_ratio,
          n_sim
        ),
        .f = \(idx_skew, n_total, n_ratio, var_ratio, n_sim) {
          # loading args
          temp_name_cond <- paste(n_total, n_ratio, sep = "_")
          temp_df_chisq <- vec_df_chisq[[as.character(idx_skew)]]
          temp_var_ratio <- vec_var_ratio[[as.character(var_ratio)]]
          # analyse
          res <- f_analyse_batch(
            n_sim = n_sim,
            df_chisq = temp_df_chisq,
            n_total = n_total,
            var_ratio = temp_var_ratio,
            vec_group = list_vec_group[[temp_name_cond]]
          )
          # progress bar update
          pb()
          # return
          res
        },
        .options = furrr::furrr_options(seed = TRUE)
      )
    ) |>
    reframe(
      do.call(
        what = rbind,
        args = temp_p
      ) |>
        data.frame(),
      .by = c(idx_skew, n_total, n_ratio, var_ratio)
    )
})

# end multisession & check
future::plan(future::sequential); future::nbrOfWorkers()- 1
-
割り振り用のdfを保持しておくのがめんどくさかったのでパイプに組み込みました。なので、引数
stepsは割り振り用のdfの行数と同じになるようにする必要があります。
8分かかりました。

Result
今回は各検定のp値をそのまま保存&一つのdfにまとめているので、結果のdfは相当重いです。object.size()で測ったR上の容量は4.3GB、parquet形式で保存したら2.7GBでした7。メモリ上に置きたいんですが、割とコンソールがフリーズしがちなので、duckdb・duckplyrを使ってparquet形式のデータを読み込むことにします。まずはとりあえずパスの固定。
データベースの読み込みにはほんの少し時間がかかってしまうので、先に有意水準\(\alpha=.2, .1, .05, .1\)のときのtype I error rateとpowerのdfを作っちゃいます。(いつものようにpost/のこの記事のところにrdsファイルで置いておくので、欲しい人はどうぞ。readr::write_rds(..., compress = "gz")で圧縮したので、readr::read_rds()で読み込めます。)
Code
1res_summary_df <- duckplyr::read_parquet_duckdb(path_sim_res) |>
2  duckplyr::as_duckdb_tibble() |>
  reframe(
    across(
      .cols = ftest:nplevene,
      .fns = \(x) {
        simhelpers::calc_rejection(
          .data,
          p_values = x,
          alpha = c(.2, .1, .05, .01)
        )
      },
      .unpack = TRUE
    ),
    .by = c(idx_skew, n_total, n_ratio, var_ratio)
  ) |>
  rename_with(
    .fn = \(x) gsub("rej_rate", replacement = "err", x = x)
  ) |>
mutate(var_ratio = as_factor(var_ratio))- 1
- parquetファイルの読み込み。
- 2
-
この後の
reframe()に対応する関数がduckplyrにない(し、reframe()内の処理の関数もない)ので、ここでこれを実行しておかないとエラーを吐く。引数prudenceがデフォルトで"lavish"なので多分ここで実体化してると思うんだけど、dplyr::collect()でもいい気がする。要勉強。
Replication of Table 1
Table 1はType I error rate の表なので、母分散比は1の条件だけでいいですね。
Code
res_summary_df |>
  filter(var_ratio == "1/1", n_total %in% c(24, 48, 96)) |>
  select(idx_skew:n_ratio, ftest = ftest_err_05, levene = levene_err_05) |>
  gt::gt(groupname_col = "idx_skew") |>
  gt::fmt_percent(columns = ftest:levene) |>
  gt::cols_move(
    columns = ftest,
    after = levene
  ) |>
  gt::text_transform(
    fn = \(x) str_c(x, "/1"),
    locations = gt::cells_body(columns = n_ratio)
  ) |>
  gt::text_case_match(
    "0" ~ "Skew \u2248 0 (df = 10000)",
    "1" ~ "Skew \u2248 1 (df = 7.4)",
    "2" ~ "Skew \u2248 2 (df = 2.2)",
    "3" ~ "Skew \u2248 3 (df = 0.83)",
    .locations = gt::cells_row_groups()
  ) |>
  gt::cols_label(
    n_total = gt::md("$N$"),
    n_ratio = gt::md("$n_1/n_2$"),
    ftest = gt::md("*F*-test"),
    levene = gt::md("SPSS's<br>Levene's<br>Test")
  ) |>
  gt::tab_style(
    style = gt::cell_text(v_align = "top"),
    locations = gt::cells_column_labels()
  ) |>
  gt::tab_header(
    title = "Replication of Table 1 of Nordstokke & Zumbo (2007)",
    subtitle = gt::md("Comparison of Empirical Type I error rate. ($\\alpha=.05$)")
  ) |>
  gt::tab_footnote(
    footnote = gt::md("100,000 iterations per condition.")
  ) |>
  gt::tab_footnote(
    footnote = gt::md("The data is generated from `rchisq(n, df)`.")
)| Replication of Table 1 of Nordstokke & Zumbo (2007) | |||
| Comparison of Empirical Type I error rate. (\(\alpha=.05\)) | |||
| \(N\) | \(n_1/n_2\) | SPSS’s Levene’s Test |
F-test |
|---|---|---|---|
| Skew ≈ 0 (df = 10000) | |||
| 24 | 1/1 | 5.87% | 5.04% |
| 24 | 2/1 | 5.79% | 4.94% |
| 24 | 3/1 | 5.63% | 4.94% |
| 48 | 1/1 | 5.43% | 5.12% |
| 48 | 2/1 | 5.44% | 5.04% |
| 48 | 3/1 | 5.44% | 5.11% |
| 96 | 1/1 | 5.22% | 5.08% |
| 96 | 2/1 | 5.24% | 4.99% |
| 96 | 3/1 | 5.23% | 5.01% |
| Skew ≈ 1 (df = 7.4) | |||
| 24 | 1/1 | 8.60% | 10.58% |
| 24 | 2/1 | 8.52% | 10.06% |
| 24 | 3/1 | 8.20% | 9.19% |
| 48 | 1/1 | 8.32% | 12.23% |
| 48 | 2/1 | 8.12% | 11.66% |
| 48 | 3/1 | 8.00% | 11.05% |
| 96 | 1/1 | 8.00% | 13.18% |
| 96 | 2/1 | 7.79% | 12.71% |
| 96 | 3/1 | 7.93% | 12.47% |
| Skew ≈ 2 (df = 2.2) | |||
| 24 | 1/1 | 14.13% | 22.49% |
| 24 | 2/1 | 13.83% | 21.36% |
| 24 | 3/1 | 13.43% | 19.41% |
| 48 | 1/1 | 13.78% | 26.09% |
| 48 | 2/1 | 13.54% | 25.14% |
| 48 | 3/1 | 13.23% | 23.77% |
| 96 | 1/1 | 13.15% | 28.04% |
| 96 | 2/1 | 12.91% | 27.23% |
| 96 | 3/1 | 12.88% | 26.42% |
| Skew ≈ 3 (df = 0.83) | |||
| 24 | 1/1 | 22.77% | 40.51% |
| 24 | 2/1 | 21.76% | 38.84% |
| 24 | 3/1 | 20.42% | 36.61% |
| 48 | 1/1 | 20.91% | 42.96% |
| 48 | 2/1 | 20.67% | 42.54% |
| 48 | 3/1 | 19.92% | 41.59% |
| 96 | 1/1 | 19.91% | 45.11% |
| 96 | 2/1 | 19.90% | 45.04% |
| 96 | 3/1 | 19.34% | 44.28% |
| 100,000 iterations per condition. | |||
The data is generated from rchisq(n, df). |
|||
まず\(Skew \approx 0\)のとき、すなわち分布がほぼ左右対称のときですが、Levene検定もF検定も5%程度になりました。これは正規分布からデータを発生させた前回と同じような感じですね。サンプルサイズが\(N=24\)と若干少ないときにLevene検定のERRが少し高めに出ているのも同じですし、F検定の方が5%の近くにいるのも同じです。
次に\(Skew \gtrapprox 1\)のときですが、どちらとも歪度が大きくなるにつれて、どのサンプルサイズ条件でも棄却率が5%よりも大きくなりました。つまり、Type I error rateを制御できていません。Levene検定はおおむね元論文通りでしたが、F検定は元論文の値よりも数値が大きくなってしまいました。使ったRfast::var2tests()の戻り値が標準のvar.test()と一致かつ内部での計算も前者が行列データを扱っていること以外同じで、どちらも元論文と同じ計算をしているのも確認したので計算違いということはないと思いますが、ちょっと不思議です8。
とりあえず、母集団分布の歪度が大きい場合はオリジナルのLevene検定もF検定もType I error rateを制御できていないという趣旨については再現できたといっていいでしょう。
Replication of Table 2
元論文のTable 2はLevene検定とF検定がType I error rateを守れている条件(\(Skew \approx 0\))下での経験的検出力の比較になります。“Inverse Pairings”がサンプルサイズが小さい群のの母分散が大きい場合、“Direct Pairings”はサンプルサイズが大きい群の母分散が大きい場合です。
Code
res_summary_df |>
  filter(idx_skew == 0, n_total %in% c(24, 48, 96)) |>
  filter_out(var_ratio == "1/1") |>
  select(n_total:var_ratio, ftest = ftest_err_05, levene = levene_err_05) |>
  mutate(
    var_ratio = fct_relevel(
      var_ratio,
      c(paste0("1/", 5:2), paste0(2:5, "/1"))
    )
  ) |>
  pivot_longer(
    cols = c(ftest, levene),
    names_to = "Test",
    values_to = "err"
  ) |>
  pivot_wider(
    names_from = var_ratio,
    names_sort = TRUE,
    values_from = err
  ) |>
  mutate(
    Test = fct_relevel(Test, "levene")
  ) |>
  arrange(n_total, n_ratio, Test) |>
  relocate(Test) |>
  gt::gt() |>
  gt::fmt_percent(
    columns = contains("/"),
    decimals = 1
  ) |>
  gt::text_case_match(
    "levene" ~ "Levene",
    "ftest" ~ gt::md("<i>F</i>"),
    .locations = gt::cells_body(columns = Test)
  ) |>
  gt::text_transform(
    fn = \(x) paste0(x, "/1"),
    locations = gt::cells_body(columns = n_ratio)
  ) |>
  gt::tab_spanner(
    label = "Inverse Pairings",
    columns = starts_with("1")
  ) |>
  gt::tab_spanner(
    label = "Direct Pairings",
    columns = ends_with("1")
  ) |>
  gt::tab_spanner(
    label = gt::md("Population Variance Ratio, $\\sigma^2_1/\\sigma^2_2$"),
    columns = contains("/")
  ) |>
  gt::cols_label(
    n_total = gt::md("$N$"),
    n_ratio = gt::md("$n_1/n_2$")
  ) |>
  gt::cols_align(
    align = "left",
    columns = Test
  ) |>
  gt::tab_style(
    style = gt::cell_borders(sides = "bottom", style = "hidden"),
    locations = gt::cells_body(rows = Test == "levene")
  ) |>
  gt::tab_style(
    style = gt::cell_borders(sides = "bottom", color = "black"),
    locations = gt::cells_body(rows = Test == "ftest")
  ) |>
  gt::tab_header(
    title = "Replication of Table 2 of Nordstokke & Zumbo (2007)",
    subtitle = gt::md("Comparison of Empirical Power. ($\\alpha=.05$)")
  ) |>
  gt::tab_footnote(
    footnote = gt::md("100,000 iterations per condition.")
  ) |>
  gt::tab_footnote(
    footnote = gt::md("The data is generated from `rchisq(n, df = 10000)`.")
)| Replication of Table 2 of Nordstokke & Zumbo (2007) | ||||||||||
| Comparison of Empirical Power. (\(\alpha=.05\)) | ||||||||||
|
Population Variance Ratio, \(\sigma^2_1/\sigma^2_2\)
|
||||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| Test | \(N\) | \(n_1/n_2\) |
Inverse Pairings
|
Direct Pairings
|
||||||
| 1/5 | 1/4 | 1/3 | 1/2 | 2/1 | 3/1 | 4/1 | 5/1 | |||
| F | 24 | 1/1 | 72.2% | 59.1% | 40.5% | 18.8% | 19.0% | 40.4% | 59.1% | 72.3% |
| F | 24 | 2/1 | 70.3% | 58.2% | 41.5% | 20.1% | 13.7% | 29.4% | 45.3% | 58.5% |
| F | 24 | 3/1 | 63.9% | 52.8% | 37.9% | 19.0% | 10.3% | 20.6% | 31.7% | 42.7% |
| F | 48 | 1/1 | 96.4% | 90.2% | 73.3% | 36.6% | 36.7% | 73.4% | 90.1% | 96.5% |
| F | 48 | 2/1 | 94.5% | 87.2% | 70.5% | 36.2% | 29.3% | 63.3% | 84.2% | 93.4% |
| F | 48 | 3/1 | 90.4% | 82.0% | 64.4% | 32.7% | 22.7% | 51.1% | 73.2% | 86.5% |
| F | 96 | 1/1 | 100.0% | 99.7% | 96.2% | 65.1% | 65.4% | 96.1% | 99.7% | 100.0% |
| F | 96 | 2/1 | 99.9% | 99.2% | 94.1% | 62.3% | 56.9% | 93.6% | 99.4% | 99.9% |
| F | 96 | 3/1 | 99.6% | 97.9% | 89.8% | 56.2% | 47.3% | 87.4% | 98.0% | 99.8% |
| 100,000 iterations per condition. | ||||||||||
The data is generated from rchisq(n, df = 10000). |
||||||||||
こちらの表に関しても、Levene検定の数値は元論文とほぼ同じになりましたが、F検定の方が多くの場合でズレました。なぞ。ただ、結論としては同じで、多くの条件(というかほとんどの条件)においてF検定の経験的検出力がLevene検定のそれを上回りました。元論文だと72条件(総サンプルサイズ3×サンプルサイズ比3×母分散比8)のうち66条件においてERRがF検定>Levene検定となっていますが、今回のシミュレーションではどうでしょう。
Code
# A tibble: 1 × 1
  `F>Levene`
       <int>
1 71単純に上回っている条件は71条件となりました9。というわけで、Table 2についても、趣旨については再現できたといっていいでしょう。
Extra: Type I error rate
では、追加分であるBF検定とnp-Levene検定についてみていきます。サンプルサイズ比が元論文より多く一枚の表にするのが大変なためグラフにしたいと思います。まずは\(\alpha=.05\)としたときの結果です。4~6%のところは背景に緑色を入れてあります。
Code
res_summary_df |>
filter(var_ratio == "1/1") |>
select(idx_skew:n_ratio, ends_with("err_05")) |>
pivot_longer(
cols = ends_with("err_05"),
names_to = c("procedures", ".value"),
names_pattern = "(.+)_(err)_05",
names_transform = list(procedures = \(x) as_factor(x))
) |>
mutate(n_ratio = as.factor(n_ratio)) |>
ggplot(aes(
x = n_total,
y = err,
group = interaction(n_ratio, procedures),
color = procedures,
linetype = n_ratio
)) +
annotate(
geom = "rect",
xmin = 9, xmax = 195,
ymin = .04, ymax = .06,
fill = "lightgreen",
alpha = .5
) +
geom_hline(yintercept = .05) +
geom_line() +
geom_point(size = .5) +
scale_x_continuous(
name = "Total Sample Size <i>N</i>",
breaks = c(12, seq(24, 192, 24)),
minor_breaks = NULL,
expand = expansion()
) +
scale_y_continuous(
name = "Empirical Rejection Rate",
breaks = seq(0, 1, .05),
minor_breaks = seq(0, 1, .025),
labels = scales::label_percent(),
expand = expansion(add = .01)
) +
scale_color_discrete(
name = "Procedures",
labels = c(
"ftest" = "*F*-test",
"levene" = "Levene",
"bf" = "Brown-Forsythe",
"nplevene" = "np-Levene"
)
) +
scale_linetype_manual(
name = "n ratio (<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub>)",
values = c("solid", "longdash", "22"),
labels = paste0(1:3, "/1") |>
setNames(nm = 1:3)
) +
facet_wrap(
vars(idx_skew),
labeller = labeller(
idx_skew = paste("Skew \u2248", 0:3) |>
setNames(nm = 0:3)
)
) +
labs(
title = "Empirical Rejection Rate (Type I error | <i>α</i> = .05)",
caption = "100,000 iterations per condition."
) +
theme_bw(base_size = 7) +
theme(
plot.title = ggtext::element_markdown(),
plot.title.position = "plot",
axis.title.x = ggtext::element_markdown(),
legend.title = ggtext::element_markdown(),
legend.text = ggtext::element_markdown()
)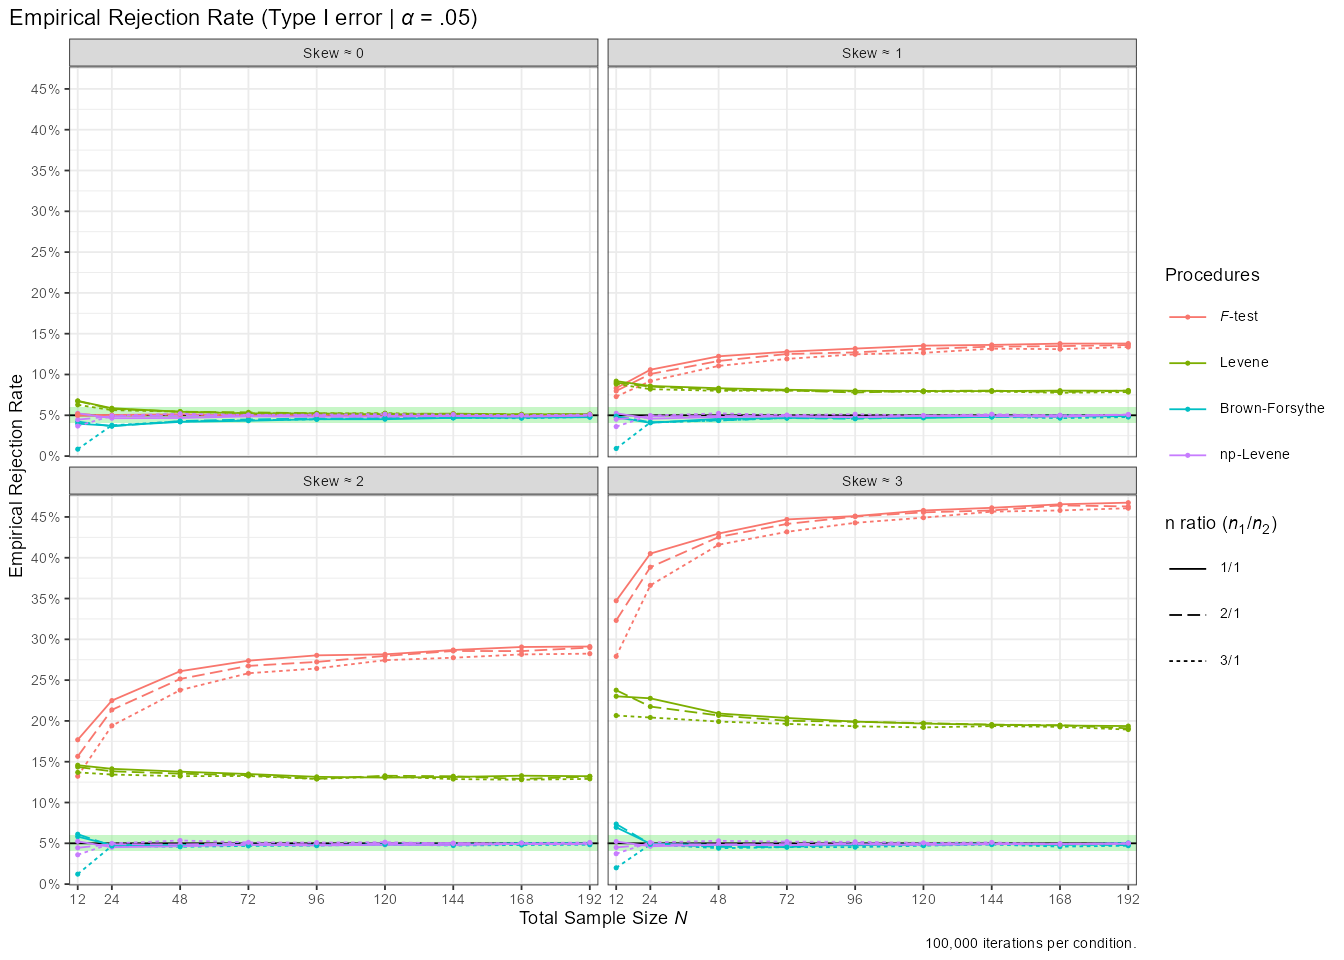
まず\(Skew \approx 0\)の条件ですが、 \(N=12\)のときにLevene検定のERRが少し高めに出ました。実際には以下の通りです。
Code
# A tibble: 3 × 5
  idx_skew n_total n_ratio levene_err_05 levene_err_mcse_05
     <int>   <int>   <int>         <dbl>              <dbl>
1        0      12       1        0.0677           0.000794
2        0      12       2        0.0673           0.000792
3        0      12       3        0.0628           0.000767
この条件だと実質的には正規分布からのデータ発生と変わらないので、Levene検定が小サンプルサイズの場合にType I error rateを微妙に制御できていない点とF検定が5%程度を維持できている点は、正規分布データでシミュレーションをした前回の記事と整合性があります。 BF検定はどの条件も5%未満になっているのですが、\(n_1/n_2\)が\(1/1, 2/1\)のときと\(3/1\)のときとでERRがかなりずれて、特に後者ではかなり保守的になっています。前回の結果も小サンプルサイズのときは保守的になっていたので、そこも整合性はあります。
Code
# A tibble: 3 × 5
  idx_skew n_total n_ratio bf_err_05 bf_err_mcse_05
     <int>   <int>   <int>     <dbl>          <dbl>
1        0      12       1   0.0397        0.000618
2        0      12       2   0.0423        0.000636
3        0      12       3   0.00847       0.000290
全体的に見ると、F検定とnp-Levene検定がおおむね5%程度を維持、BF検定が若干保守的でサンプルサイズが大きくなると5%に近づく、Levene検定は小サンプルサイズ時に若干リベラルで、サンプルサイズが大きくなるにつれて5%に近づくという感じでした。
次に\(Skew \gtrapprox 1\)の条件ですが、グラフの形はどれも似通っています。 それぞれ見ていきましょう。
- F検定
- Type I error rateを制御できていません。総サンプルサイズが大きくなるにつれて割合が上昇しています。上昇の仕方は直線的ではなく、サンプルサイズが大きくなると一定の値に収束しそうですね。サンプルサイズ比の影響は総サンプルサイズが少ないときの方が大きそうです。
- Levene検定
- Type I error rateを制御できていません。F検定とは逆で総サンプルサイズが大きくなるにつれて割合が低下している(かあまり変わらなくなってるようにも)見受けられます。サンプルサイズ比については\(Skew \gtrapprox 2\)の小サンプルサイズのときに影響がありそうに見えます。
- BF検定
- これが一番面白くて、基本的にはType I error rateを制御できているんですが、\(Skew \approx 0\)のときと同じで総サンプルサイズ12のときの挙動がおもしろいです。\(n_1/n_2=3/1\)のときだけ極端に保守的で、それ以外の場合は逆にリベラルになっています。特に\(Skew \approx 3\)ときは7%程度にまでなっています。\(N=12\)のときのサンプルサイズ比\(2/1, 3/1\)だと\((n_1,n_2) = (8,4), (9,3)\)でほとんど違いがないのに驚きです。前者が中央値の計算で÷2が出てきて、後者では単に2番目の値がそのまま使われるというところにミソがあるのでしょうか?
Code
# A tibble: 9 × 5
  idx_skew n_total n_ratio bf_err_05 bf_err_mcse_05
     <int>   <int>   <int>     <dbl>          <dbl>
1        1      12       1   0.0476        0.000673
2        1      12       2   0.0489        0.000682
3        1      12       3   0.00926       0.000303
4        2      12       1   0.0582        0.000740
5        2      12       2   0.0612        0.000758
6        2      12       3   0.0122        0.000347
7        3      12       1   0.0696        0.000805
8        3      12       2   0.0736        0.000826
9 3 12 3 0.0200 0.000442- np-Levene検定
- 4つの中だと一番安定していました。ただ、BF検定と同じで総サンプルサイズ12で\(n_1/n_2=3/1\)のときのERRが若干低めに出ているように見受けられます。
\(\alpha=.01\)での結果も見ておきます。緑色の範囲は0.5~1.5%でとっています。
Code
res_summary_df |>
filter(var_ratio == "1/1") |>
select(idx_skew:n_ratio, ends_with("err_01")) |>
pivot_longer(
cols = ends_with("err_01"),
names_to = c("procedures", ".value"),
names_pattern = "(.+)_(err)_01",
names_transform = list(procedures = \(x) as_factor(x))
) |>
mutate(n_ratio = as.factor(n_ratio)) |>
ggplot(aes(
x = n_total,
y = err,
group = interaction(n_ratio, procedures),
color = procedures,
linetype = n_ratio
)) +
annotate(
geom = "rect",
xmin = 9, xmax = 195,
ymin = .005, ymax = .015,
fill = "lightgreen",
alpha = .5
) +
geom_hline(yintercept = .01) +
geom_line() +
geom_point(size = .5) +
scale_x_continuous(
name = "Total Sample Size <i>N</i>",
breaks = c(12, seq(24, 192, 24)),
minor_breaks = NULL,
expand = expansion()
) +
scale_y_continuous(
name = "Empirical Rejection Rate",
limits = c(0, NA),
breaks = c(0, .01, seq(.05, 1, .05)),
minor_breaks = seq(0, 1, .01),
labels = scales::label_percent(),
expand = expansion(add = c(.005, .01))
) +
scale_color_discrete(
name = "Procedures",
labels = c(
"ftest" = "*F*-test",
"levene" = "Levene",
"bf" = "Brown-Forsythe",
"nplevene" = "np-Levene"
)
) +
scale_linetype_manual(
name = "n ratio (<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub>)",
values = c("solid", "longdash", "22"),
labels = paste0(1:3, "/1") |>
setNames(nm = 1:3)
) +
facet_wrap(
vars(idx_skew),
labeller = labeller(
idx_skew = paste("Skew \u2248", 0:3) |>
setNames(nm = 0:3)
)
) +
labs(
title = "Empirical Rejection Rate (Type I error | <i>α</i> = .01)",
caption = "100,000 iterations per condition."
) +
theme_bw(base_size = 7) +
theme(
plot.title = ggtext::element_markdown(),
plot.title.position = "plot",
axis.title.x = ggtext::element_markdown(),
legend.title = ggtext::element_markdown(),
legend.text = ggtext::element_markdown()
)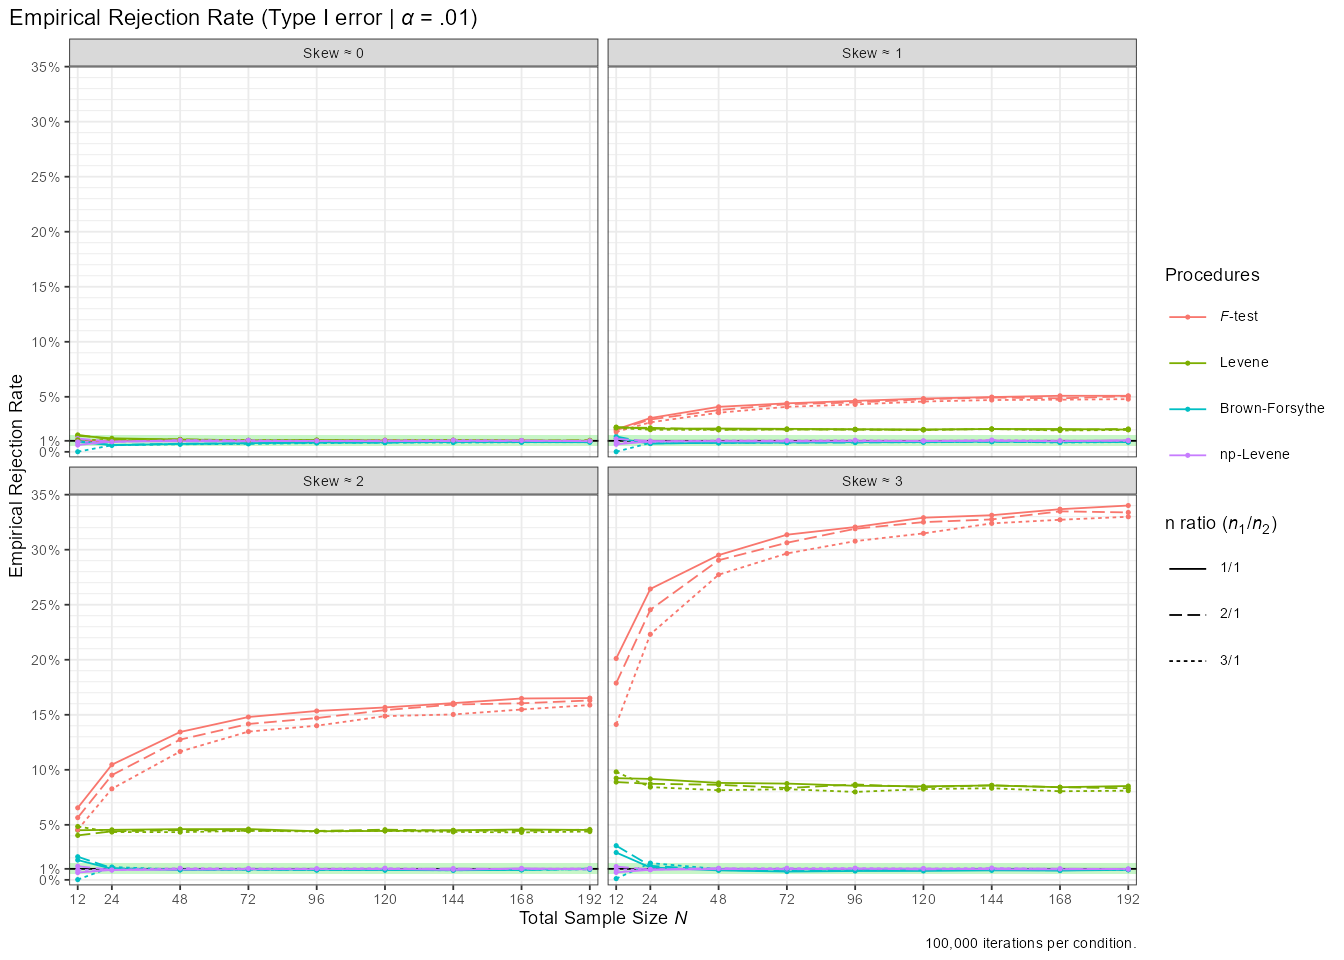
\(\alpha=.05\)のときと同じような傾向が見られました。
総サンプルサイズ12のときが気になるのでECDFを見てみます。今回p値をそのまま保存できるようにしたのはこのためです。参考として\(p=.05, .1\)のところに線を入れておきます。Type I error rateの場合、対角線上に線が載っていれば理想です。
Code
duckplyr::read_parquet_duckdb(path_sim_res) |>
1  filter(var_ratio == "1/1", n_total == 12) |>
  select(-var_ratio) |>
2  duckplyr::as_duckdb_tibble() |>
  pivot_longer(
    cols = ftest:nplevene,
    names_to = "procedures",
    names_transform = \(x) as_factor(x),
    values_to = "pvalue"
  ) |>
  group_by(idx_skew) |>
3  group_walk(
    .f = \(x, idx) {
      temp <- x |>
        ggplot(aes(x = pvalue, color = procedures)) +
        annotate(
          geom = "segment",
          x = 0, xend = 1,
          y = 0, yend = 1
        ) +
        annotate(
          geom = "segment",
          x = 0, xend = c(.05, .1),
          y = c(.05, .1), yend = c(.05, .1)
        ) +
        annotate(
          geom = "segment",
          x = c(.05, .1), xend = c(.05, .1),
          y = 0, yend = c(.05, .1)
        ) +
        stat_ecdf(pad = FALSE) +
        scale_x_continuous(
          breaks = c(0, .05, seq(.1, 1, .1)),
          minor_breaks = seq(.15, 1, .1),
          labels = c(0, .05, seq(.1, 1, .1)) |>
            format() |>
            gsub("(\\.*0+$|^0(?!\\.00))", replacement = "", x = _, perl = TRUE),
          expand = expansion(add = .01)
        ) +
        scale_y_continuous(
          breaks = c(0, .05, seq(.1, 1, .1)),
          minor_breaks = seq(.15, 1, .1),
          labels = scales::label_percent(),
          expand = expansion(add = .01)
        ) +
        scale_color_discrete(
          name = "Procedures",
          labels = c(
            "ftest" = "*F*-test",
            "levene" = "Levene",
            "bf" = "Brown-Forsythe",
            "nplevene" = "np-Levene"
          )
        ) +
        labs(
          title = paste(
            "Skew \u2248", idx$idx_skew,
            "| Total Sample Size *N* = 12",
            "| $\\sigma_1^2 / \\sigma_2^2$ = 1/1"
          ),
          caption = "100,000 iterations per condition."
        ) +
        facet_wrap(
          vars(n_ratio),
          labeller = labeller(
            n_ratio = paste0(
              "<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
              1:3,
              "/1"
            ) |>
              setNames(1:3)
          )
        ) +
        theme_bw(base_size = 7) +
        theme(
          plot.title.position = "plot",
          plot.title = gridmicrotex::element_markdown(),
          strip.text = ggtext::element_markdown(),
          legend.position = "top",
          legend.text = ggtext::element_markdown()
        )
      print(temp)
    }
)- 1
-
ここら辺は全部
duckplyrでの処理になっているはず。 - 2
-
これしておかないと
tidyr::pivot_longer()が通らない。dplyr::collect()にしても動いた。 - 3
-
チャンクオプションで
results: hideとかにしてるのに、なぜかインデックスが出てきちゃうので、group_walk()とprint()の組み合わせで無理やり表示してます。
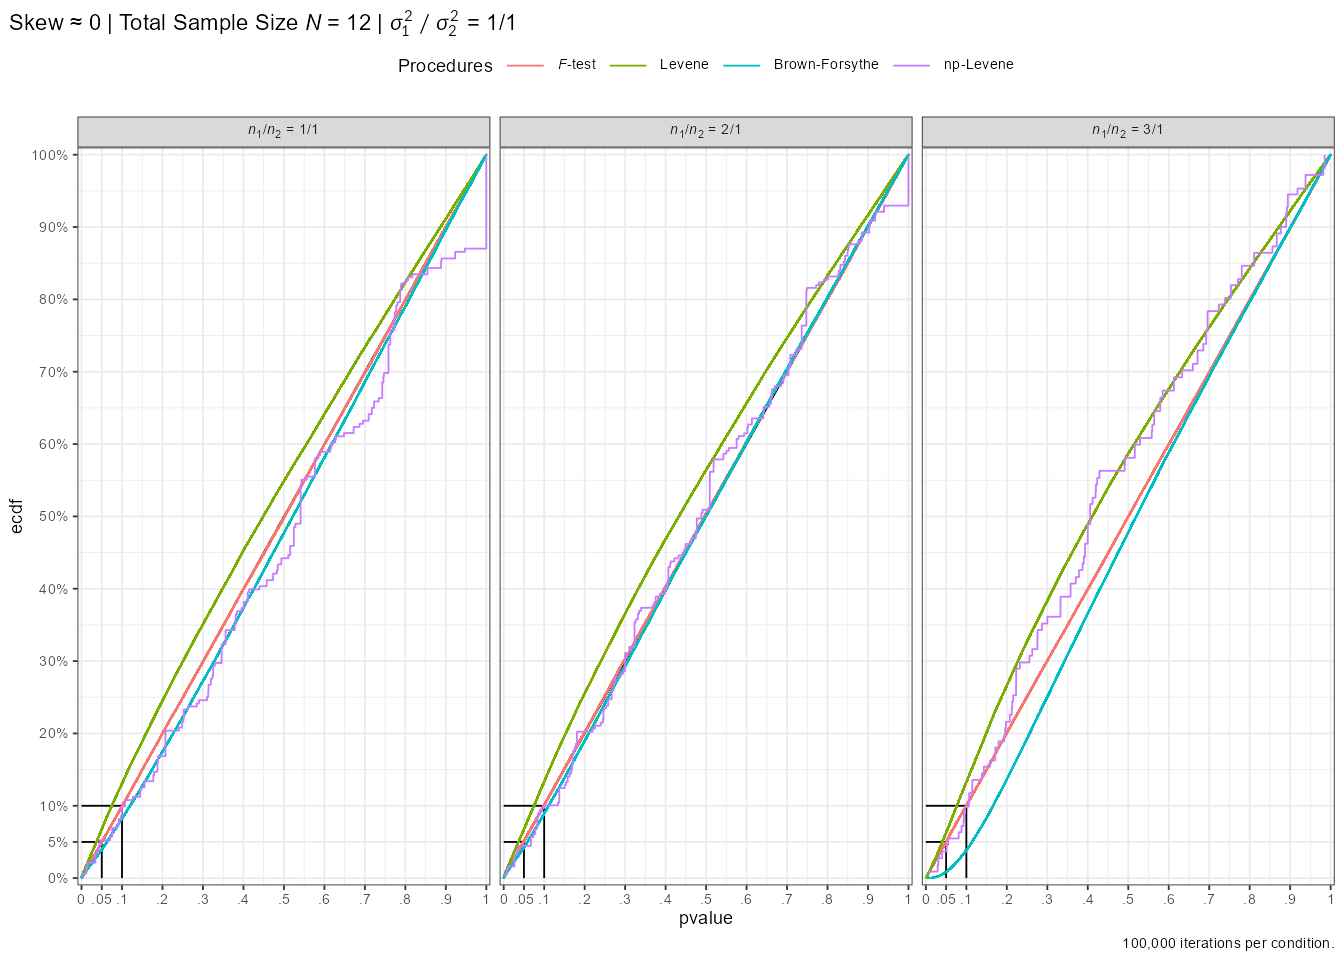
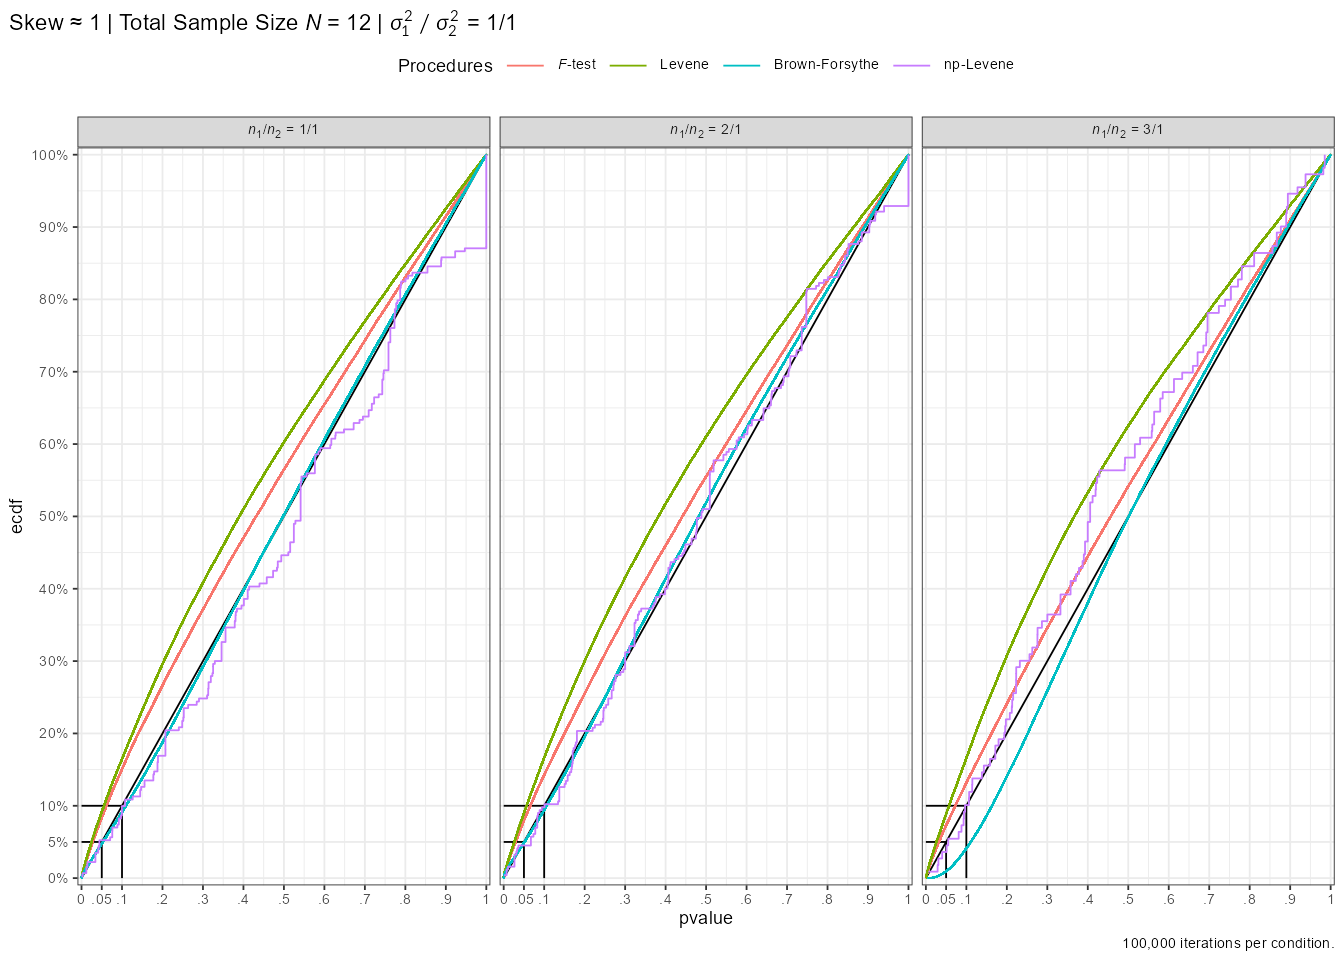
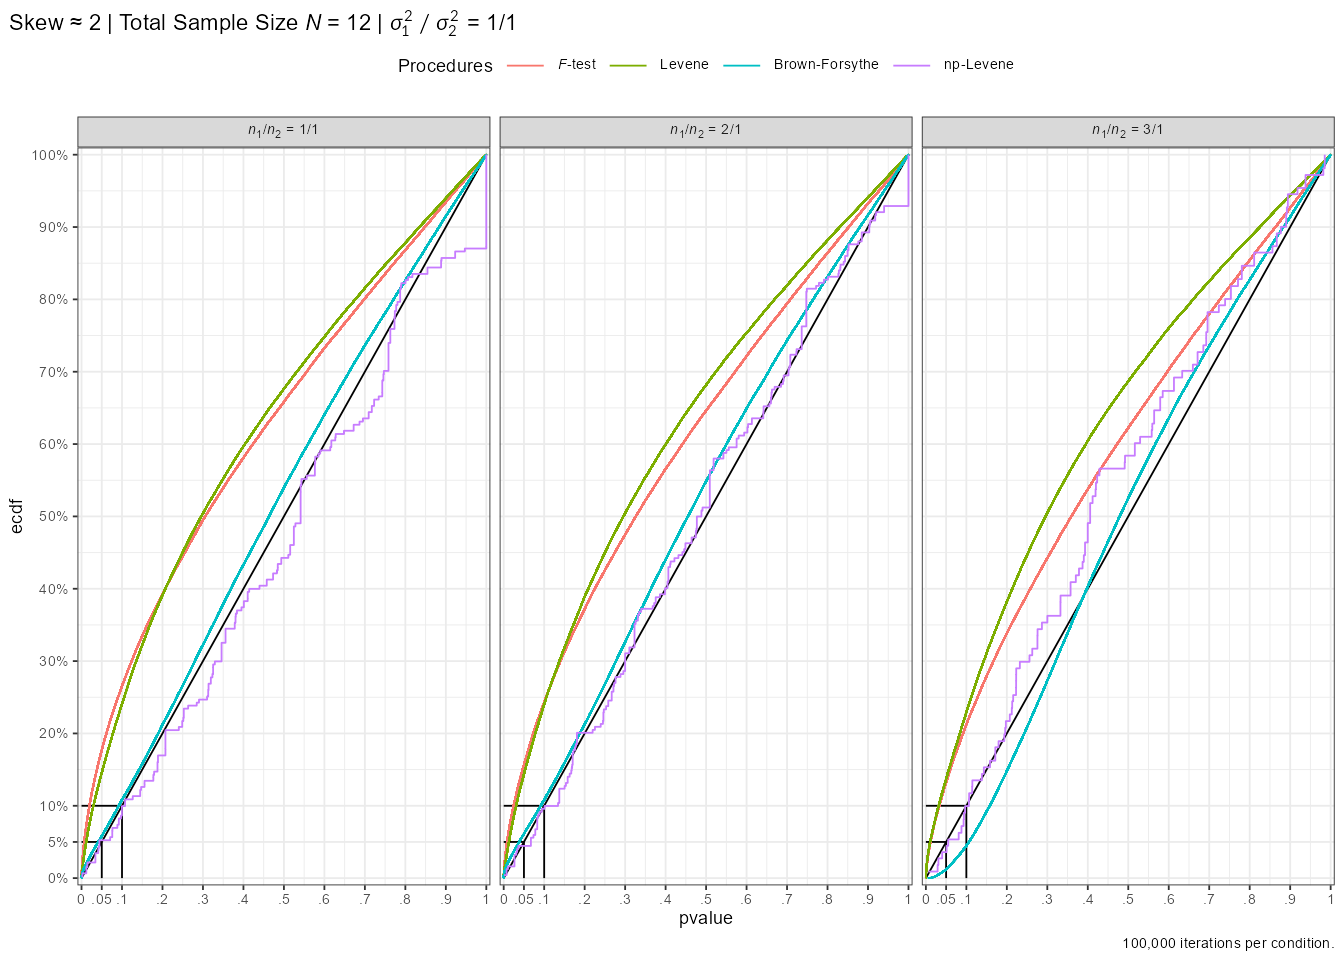
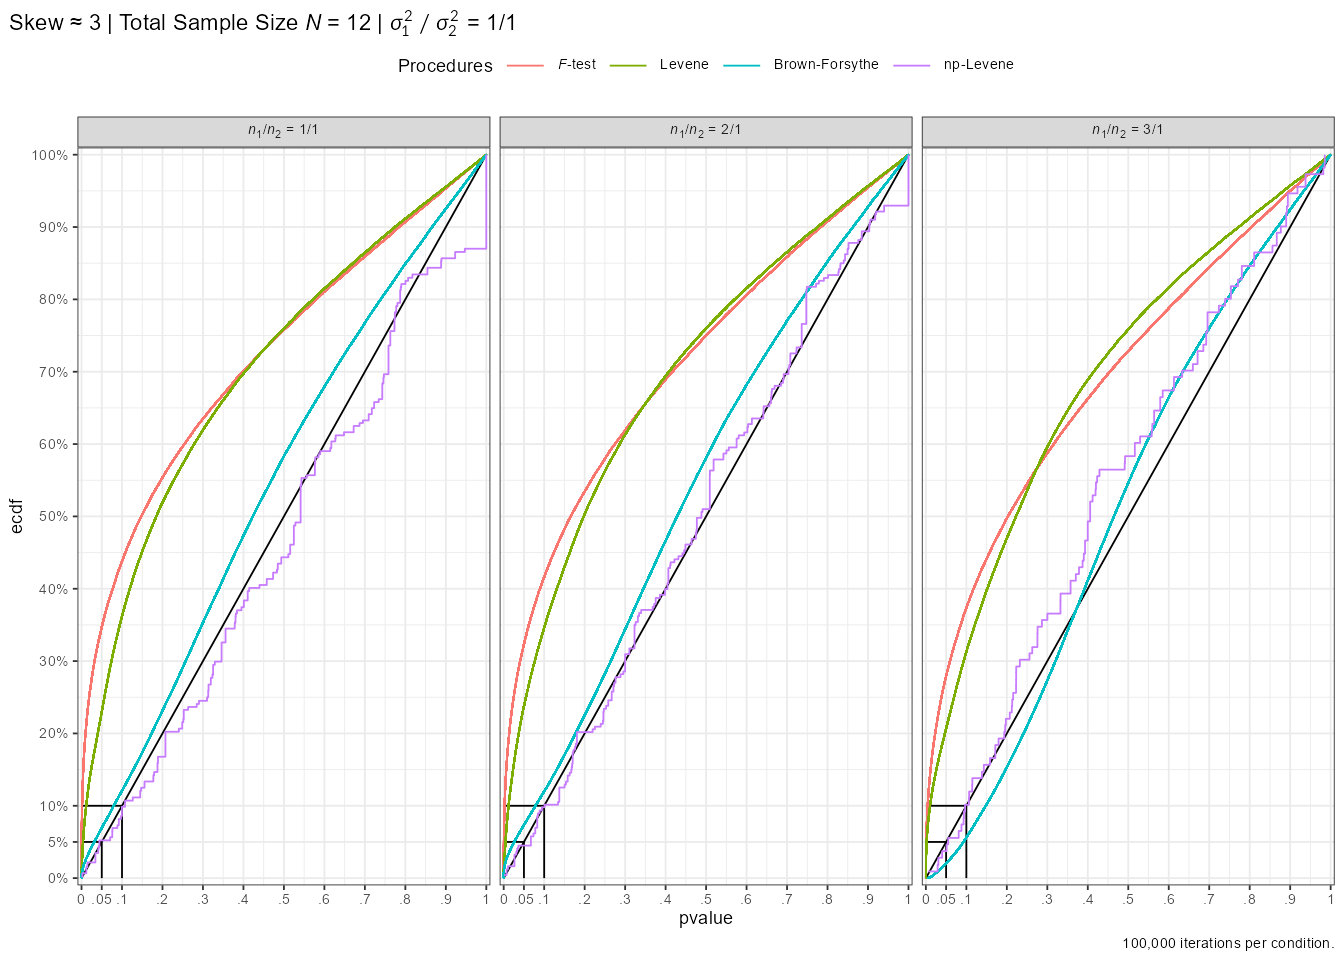
例えば、\(Skew \approx 0\)のときのF検定は、どの条件でもほぼ対角線上に載っています。.05以下のp値は全体の5%、.10以下のp値は全体の10%、…となるので有意水準αをいくつにしても、α以下のp値は大体α%になるというわけです。ヒストグラムを作るとおそらく一様分布っぽい形になります。 一方でLevene検定は対角線より上にあるので、.05以下のp値は5%よりも若干多い。すなわち小さいp値が出がちでそれはつまり有意水準αを守れていないことにつながっています。 反対に、BF検定は特に\(n_1/n_2=3/1\)で対角線の下に出ています。例えば.05以下のp値はほとんどない(実際に0.8%くらいだった)わけです。一方でそれ以外の場合は対角線より若干上にあるので、有意水準αで若干値が上振れていたのもわかります。
np-Levene検定の線はガクガクになっていて面白いです。これは同じp値が出てきたときによく起こります。例えば、\(n_1/n_2=1/1\)のときのp値が1のところ見ると急激に線が上がっています。おそらく検定結果が\(p = 1\)となった回数がかなり多いはずです。
Code
# A duckplyr data frame: 1 variable
      n
  <int>
1 12769
実際には12769回なので12%ほどですね。こういったなめらかではない線は、2×2の分割表のシミュレーションでフィッシャーの正確確率検定なんかのp値のECDFを作るときにも見られます。ノンパラメトリックな手法とか数え上げ系だとこうなりがちだと思います。
他の条件でもECDFのグラフを作りたいのですが、Type I error rateの条件だけでも108条件あるので、すべての条件で見やすい形で作るのは難しいです。とりあえず歪度ごとに分けて作ってみました。行にサンプルサイズ比、列に検定を並べています。線の色が総サンプルサイズで、対角線のy±1%に点線を作ってあります。(クリックで拡大)
ちなみに、昔、本で読んだか誰かに教わっただか覚えていないのですが、t検定の前の等分散性の検定についてはよりリベラルな有意水準でよい(例えば\(\alpha=.1, .2\))とする説があったと思います。それならType I error rate を制御できているのではないかという人がいるかもしれませんが、ECDFの横軸pvalueの\(\alpha=.1, .2\)のときのy軸の値を見てもらえればわかると思います。
Code
duckplyr::read_parquet_duckdb(path_sim_res) |>
  filter(var_ratio == "1/1") |>
  collect() |>
  pivot_longer(
    cols = ftest:nplevene,
    names_to = "procedures",
    names_transform = \(x) as_factor(x),
    values_to = "pvalue"
  ) |>
  mutate(n_total = as.factor(n_total)) |>
  group_by(idx_skew) |>
  group_map(
    .f = \(x, idx) {
      temp_plot <- x |>
        ggplot(aes(
          x = pvalue,
          group = n_total,
          color = n_total
        )) +
        annotate(
          geom = "segment",
          x = 0, xend = 1,
          y = 0, yend = 1,
          linetype = "dashed"
        ) +
        annotate(
          geom = "ribbon",
          x = c(0, 1),
          y = c(0, 1),
          ymin = c(0 ,1) - .01,
          ymax = c(0, 1) + .01,
          fill = NA,
          color = "black",
          linetype = "11",
          linewidth = .2
        ) +
        stat_ecdf(
          pad = FALSE,
          linewidth = .2
        ) +
        scale_color_viridis_d(
          begin = .1,
          end = .9,
          option = "turbo"
        ) +
        scale_x_continuous(
          breaks = c(0, .05, seq(.1, 1, .1)),
          minor_breaks = seq(.15, 1, .05),
          labels = c(0, .05, seq(.1, 1, .1)) |>
            format() |>
            gsub("(\\.*0+$|^0(?!\\.00))", replacement = "", x = _, perl = TRUE)
        ) +
        scale_y_continuous(
          breaks = c(0, .05, seq(.1, 1, .1)),
          minor_breaks = seq(.15, 1, .05),
          labels = scales::label_percent()
        ) +
        facet_grid(
          rows = vars(n_ratio),
          cols = vars(procedures),
          labeller = labeller(
            n_ratio = paste0(
              "<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
              1:3, "/1"
            ) |>
              setNames(1:3),
            procedures = c(
              "ftest" = "*F*-test",
              "levene" = "Levene",
              "bf" = "Brown-Forsythe",
              "nplevene" = "np-Levene"
            )
          )
        ) +
        labs(
          title = paste0(
            "ECDF (Skew \u2248 ",
            idx$idx_skew,
            "| $\\sigma_1^2/\\sigma_2^2=1/1$)"
          ),
          color = "*N*"
        ) +
1        coord_cartesian(
          xlim = c(-.01, 1.01),
          ylim = c(-.01, 1.01),
          expand = FALSE
        ) +
        theme_bw(base_size = 6) +
        theme(
          plot.title = gridmicrotex::element_markdown(),
          plot.title.position = "plot",
          panel.grid = element_line(linewidth = .1),
          strip.text.x = ggtext::element_markdown(),
          strip.text.y = ggtext::element_markdown(),
          legend.title = ggtext::element_markdown()
        )
      ggsave(
        paste0(
          "rep_nordstokke_zumbo_2007_type1error_ecdf_skew",
          idx$idx_skew,
          ".png"
        ),
        plot = temp_plot,
        width = 8,
        height = 6
      )
    }
)- 1
-
ggplot2::scale_*(expand = ...)でギリギリを狙うとggplot2::annotate(geom = "ribbon", ...)が消えちゃうので、ggplot2::coord_cartesian()のlimをpadding込みで設定した。coord_cartesian()の引数expandはlgl型しか受け付けないらしい。数値で設定させてほしい!
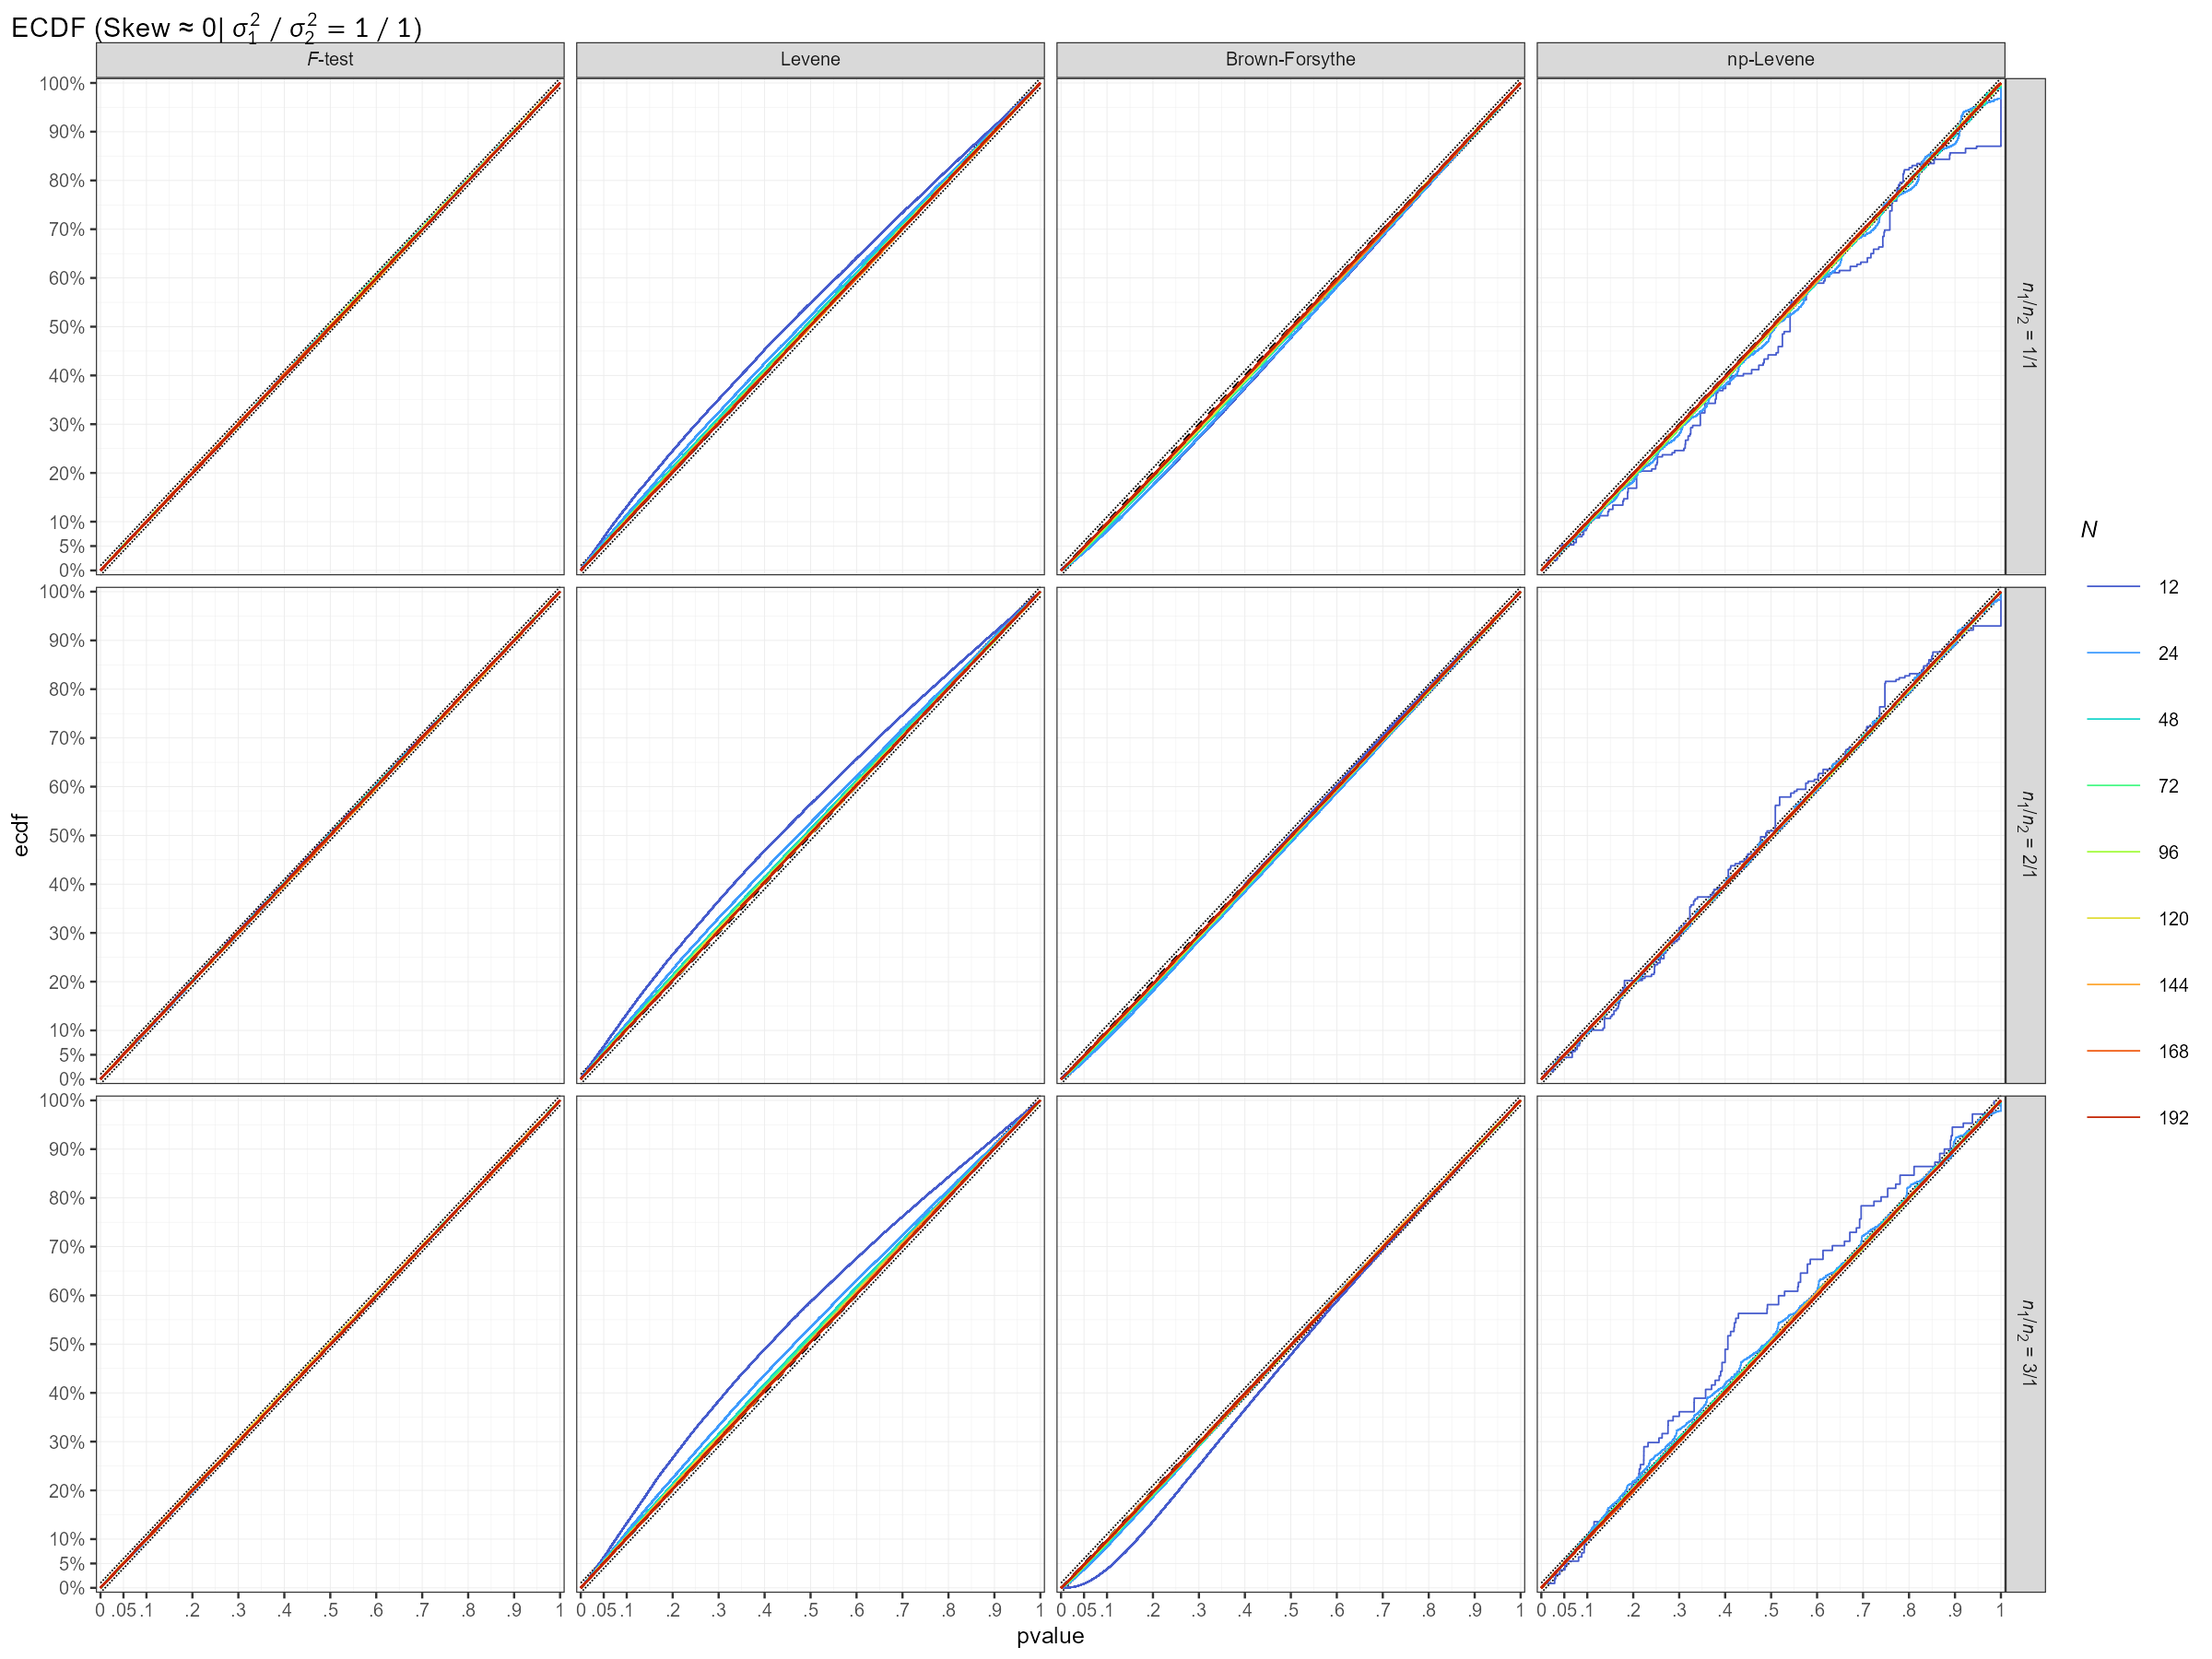
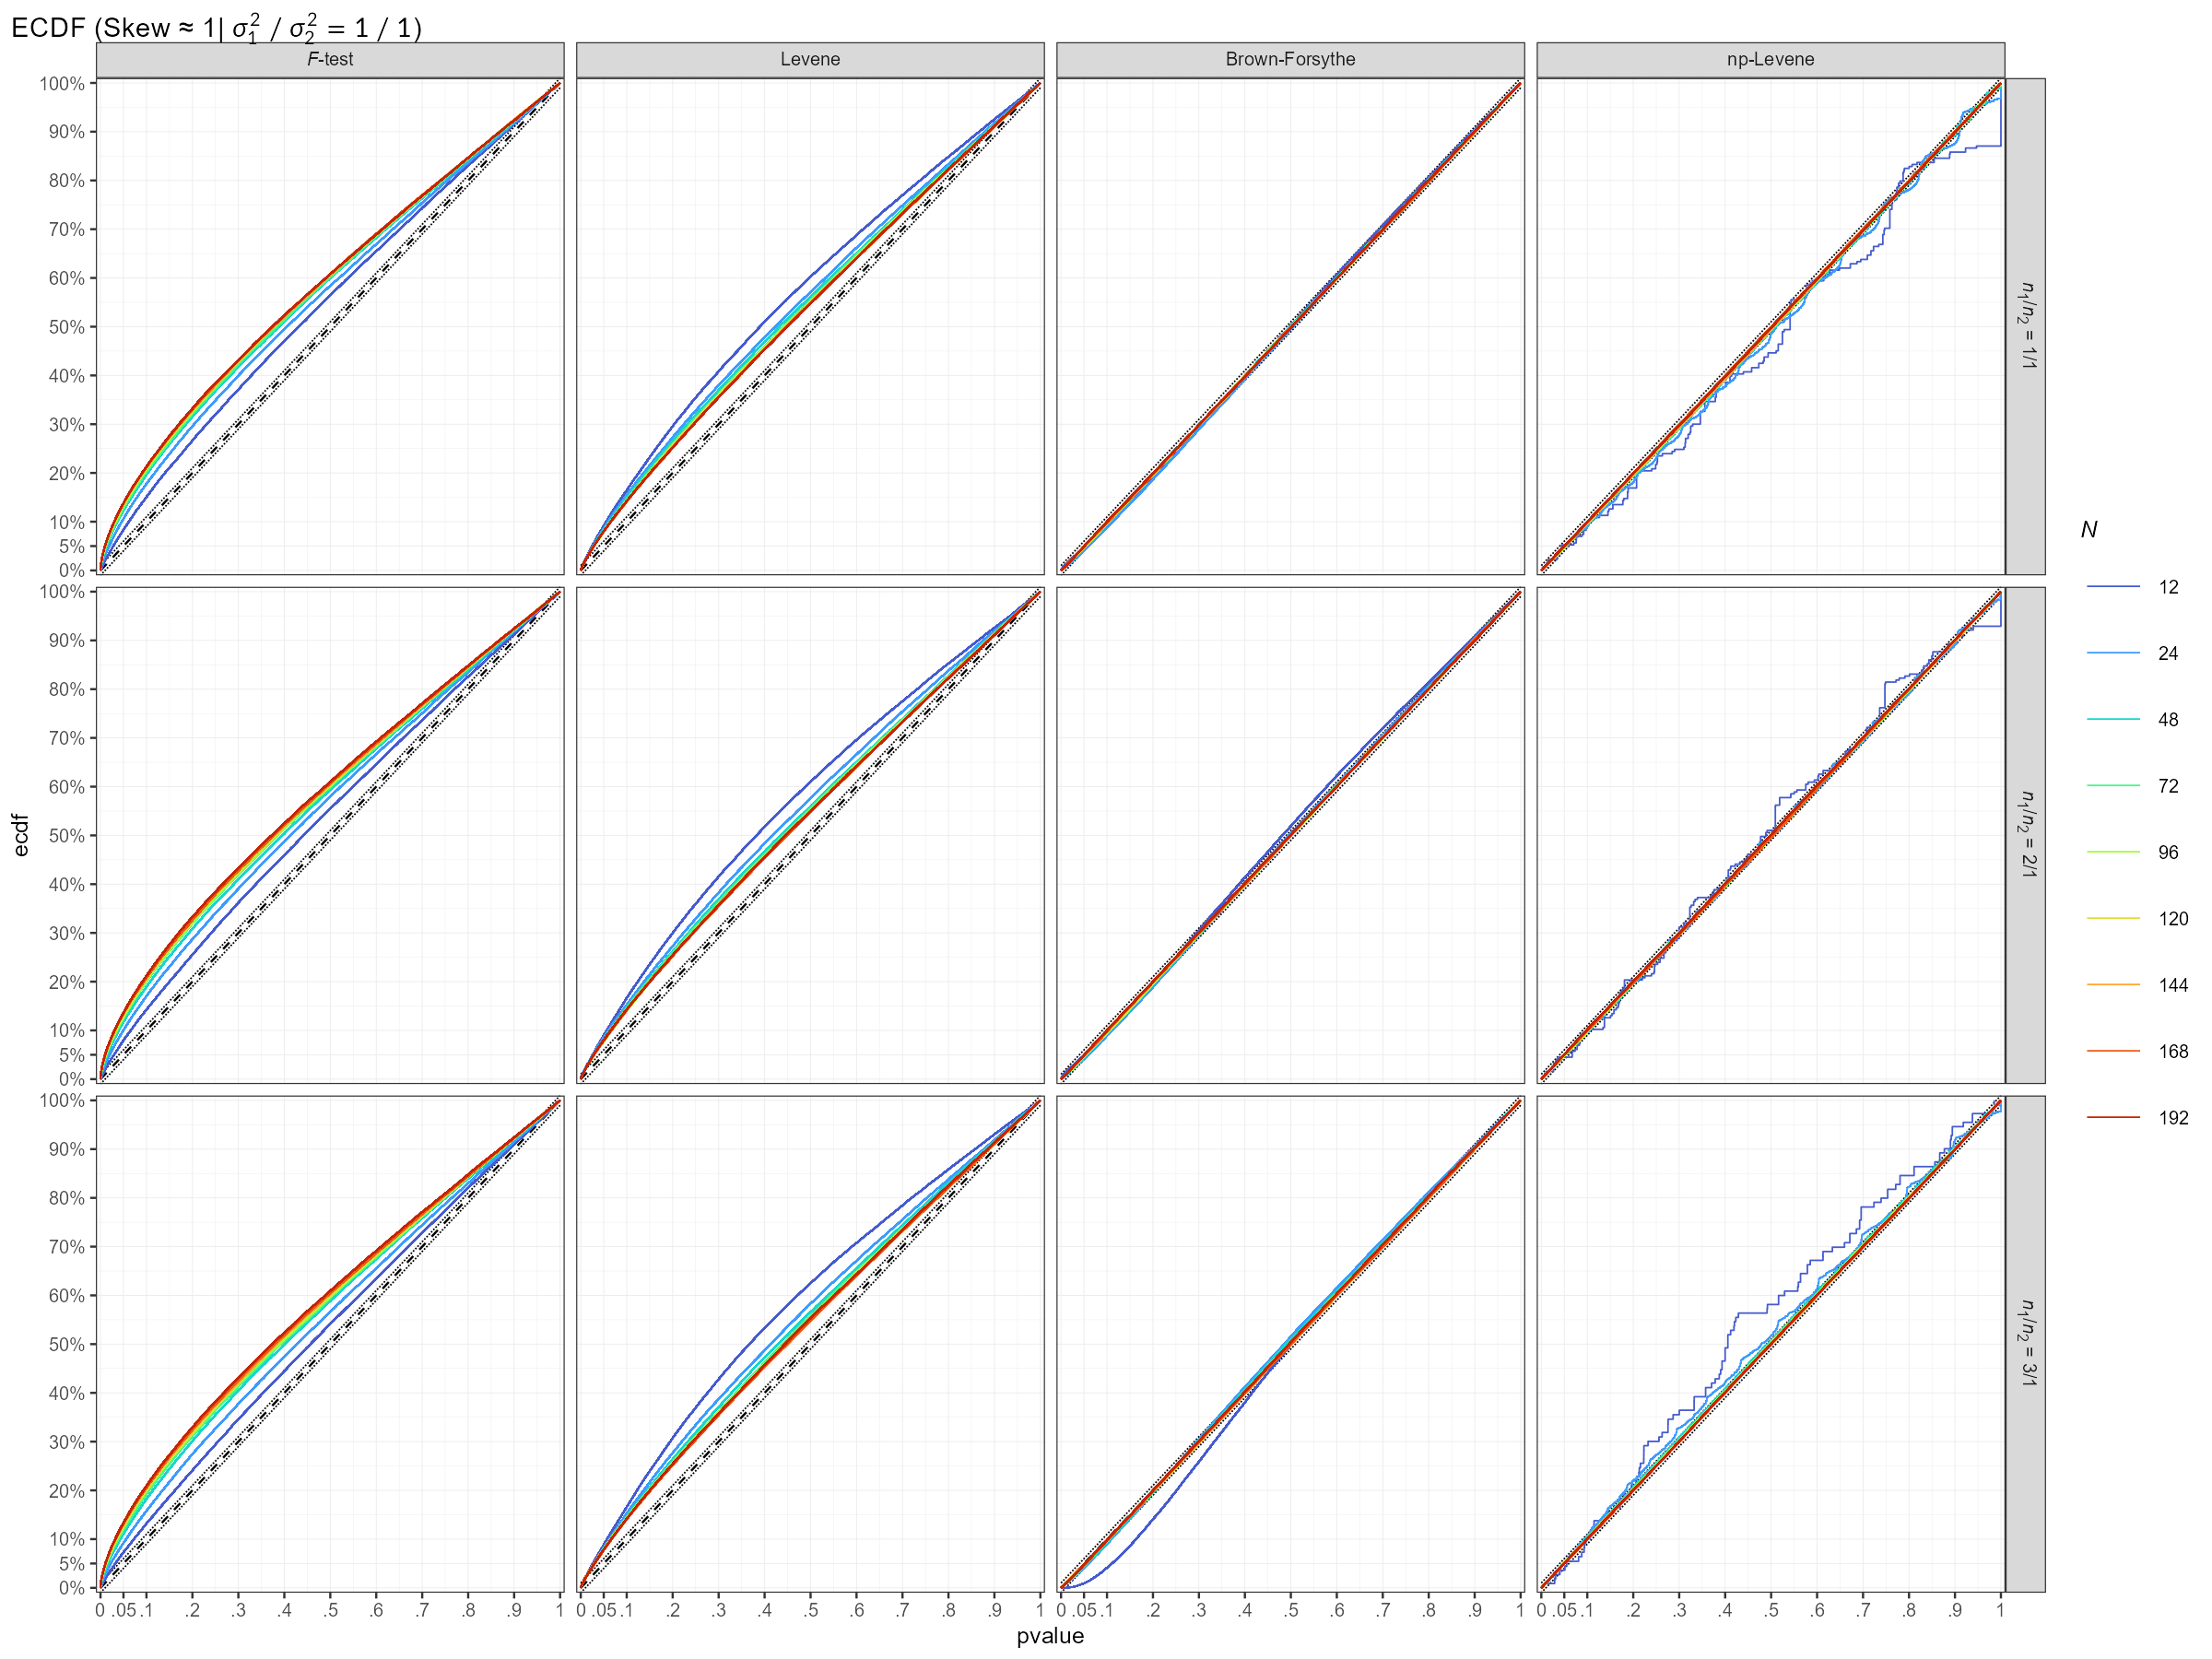
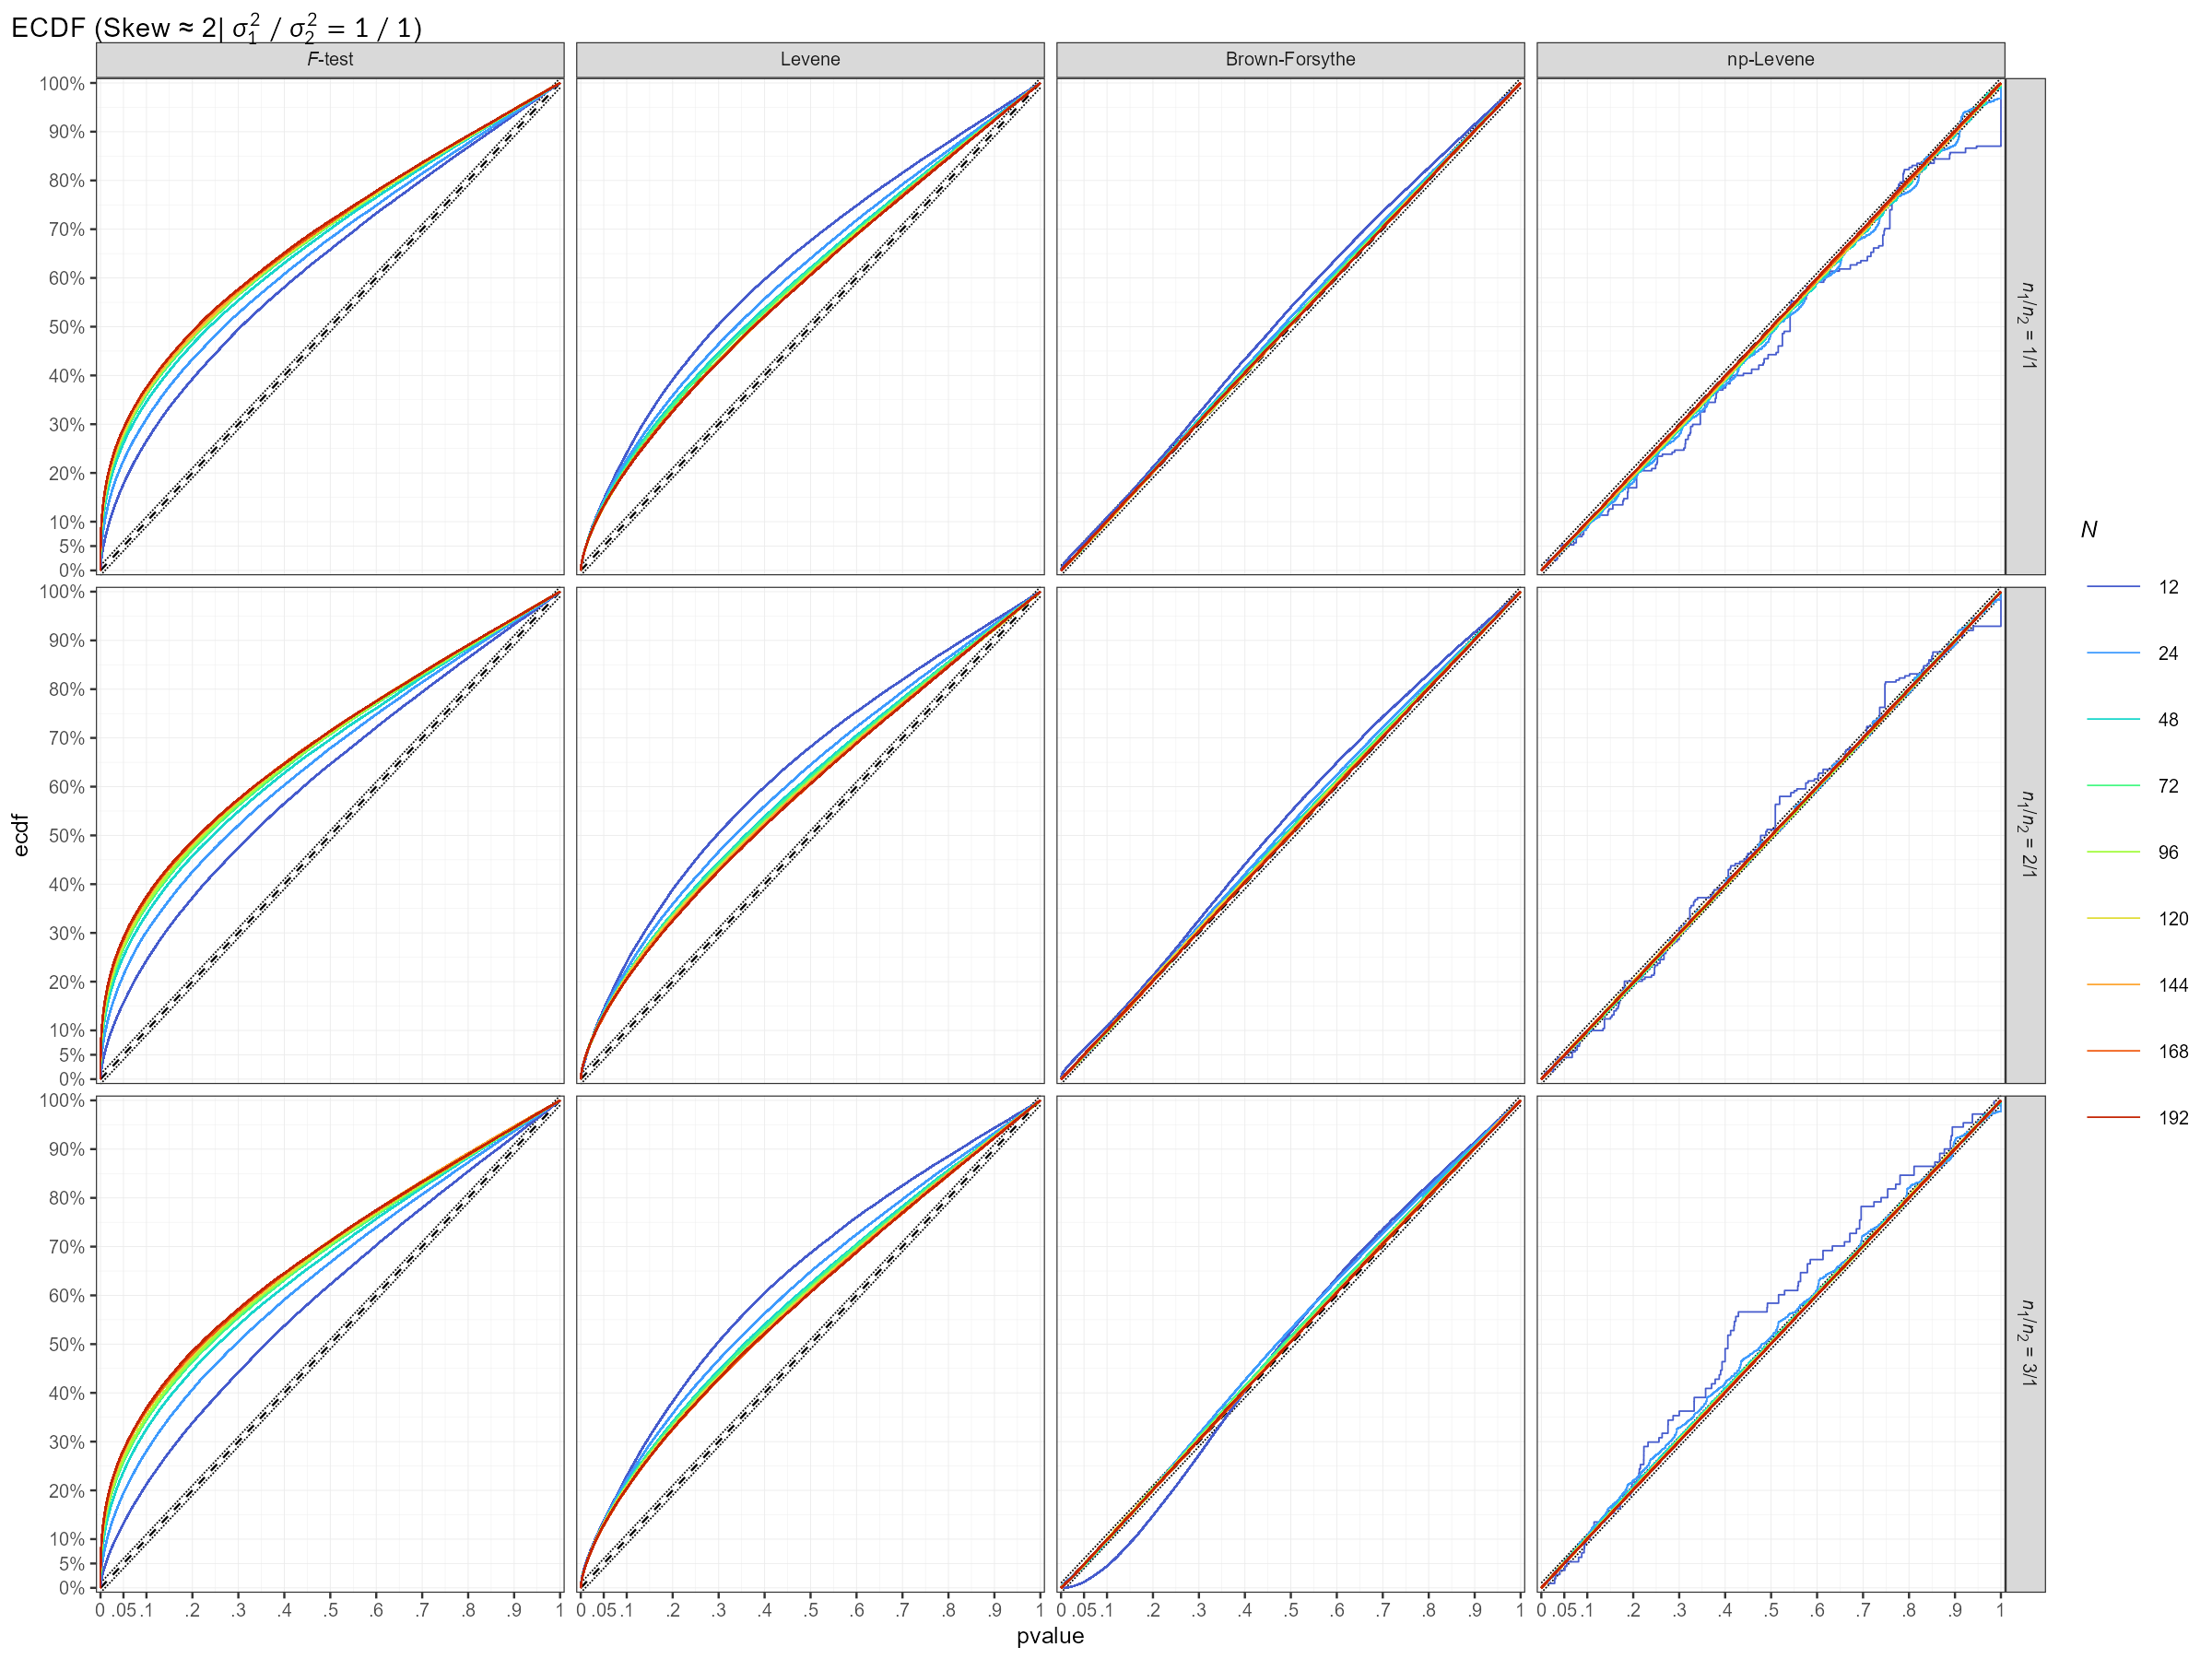
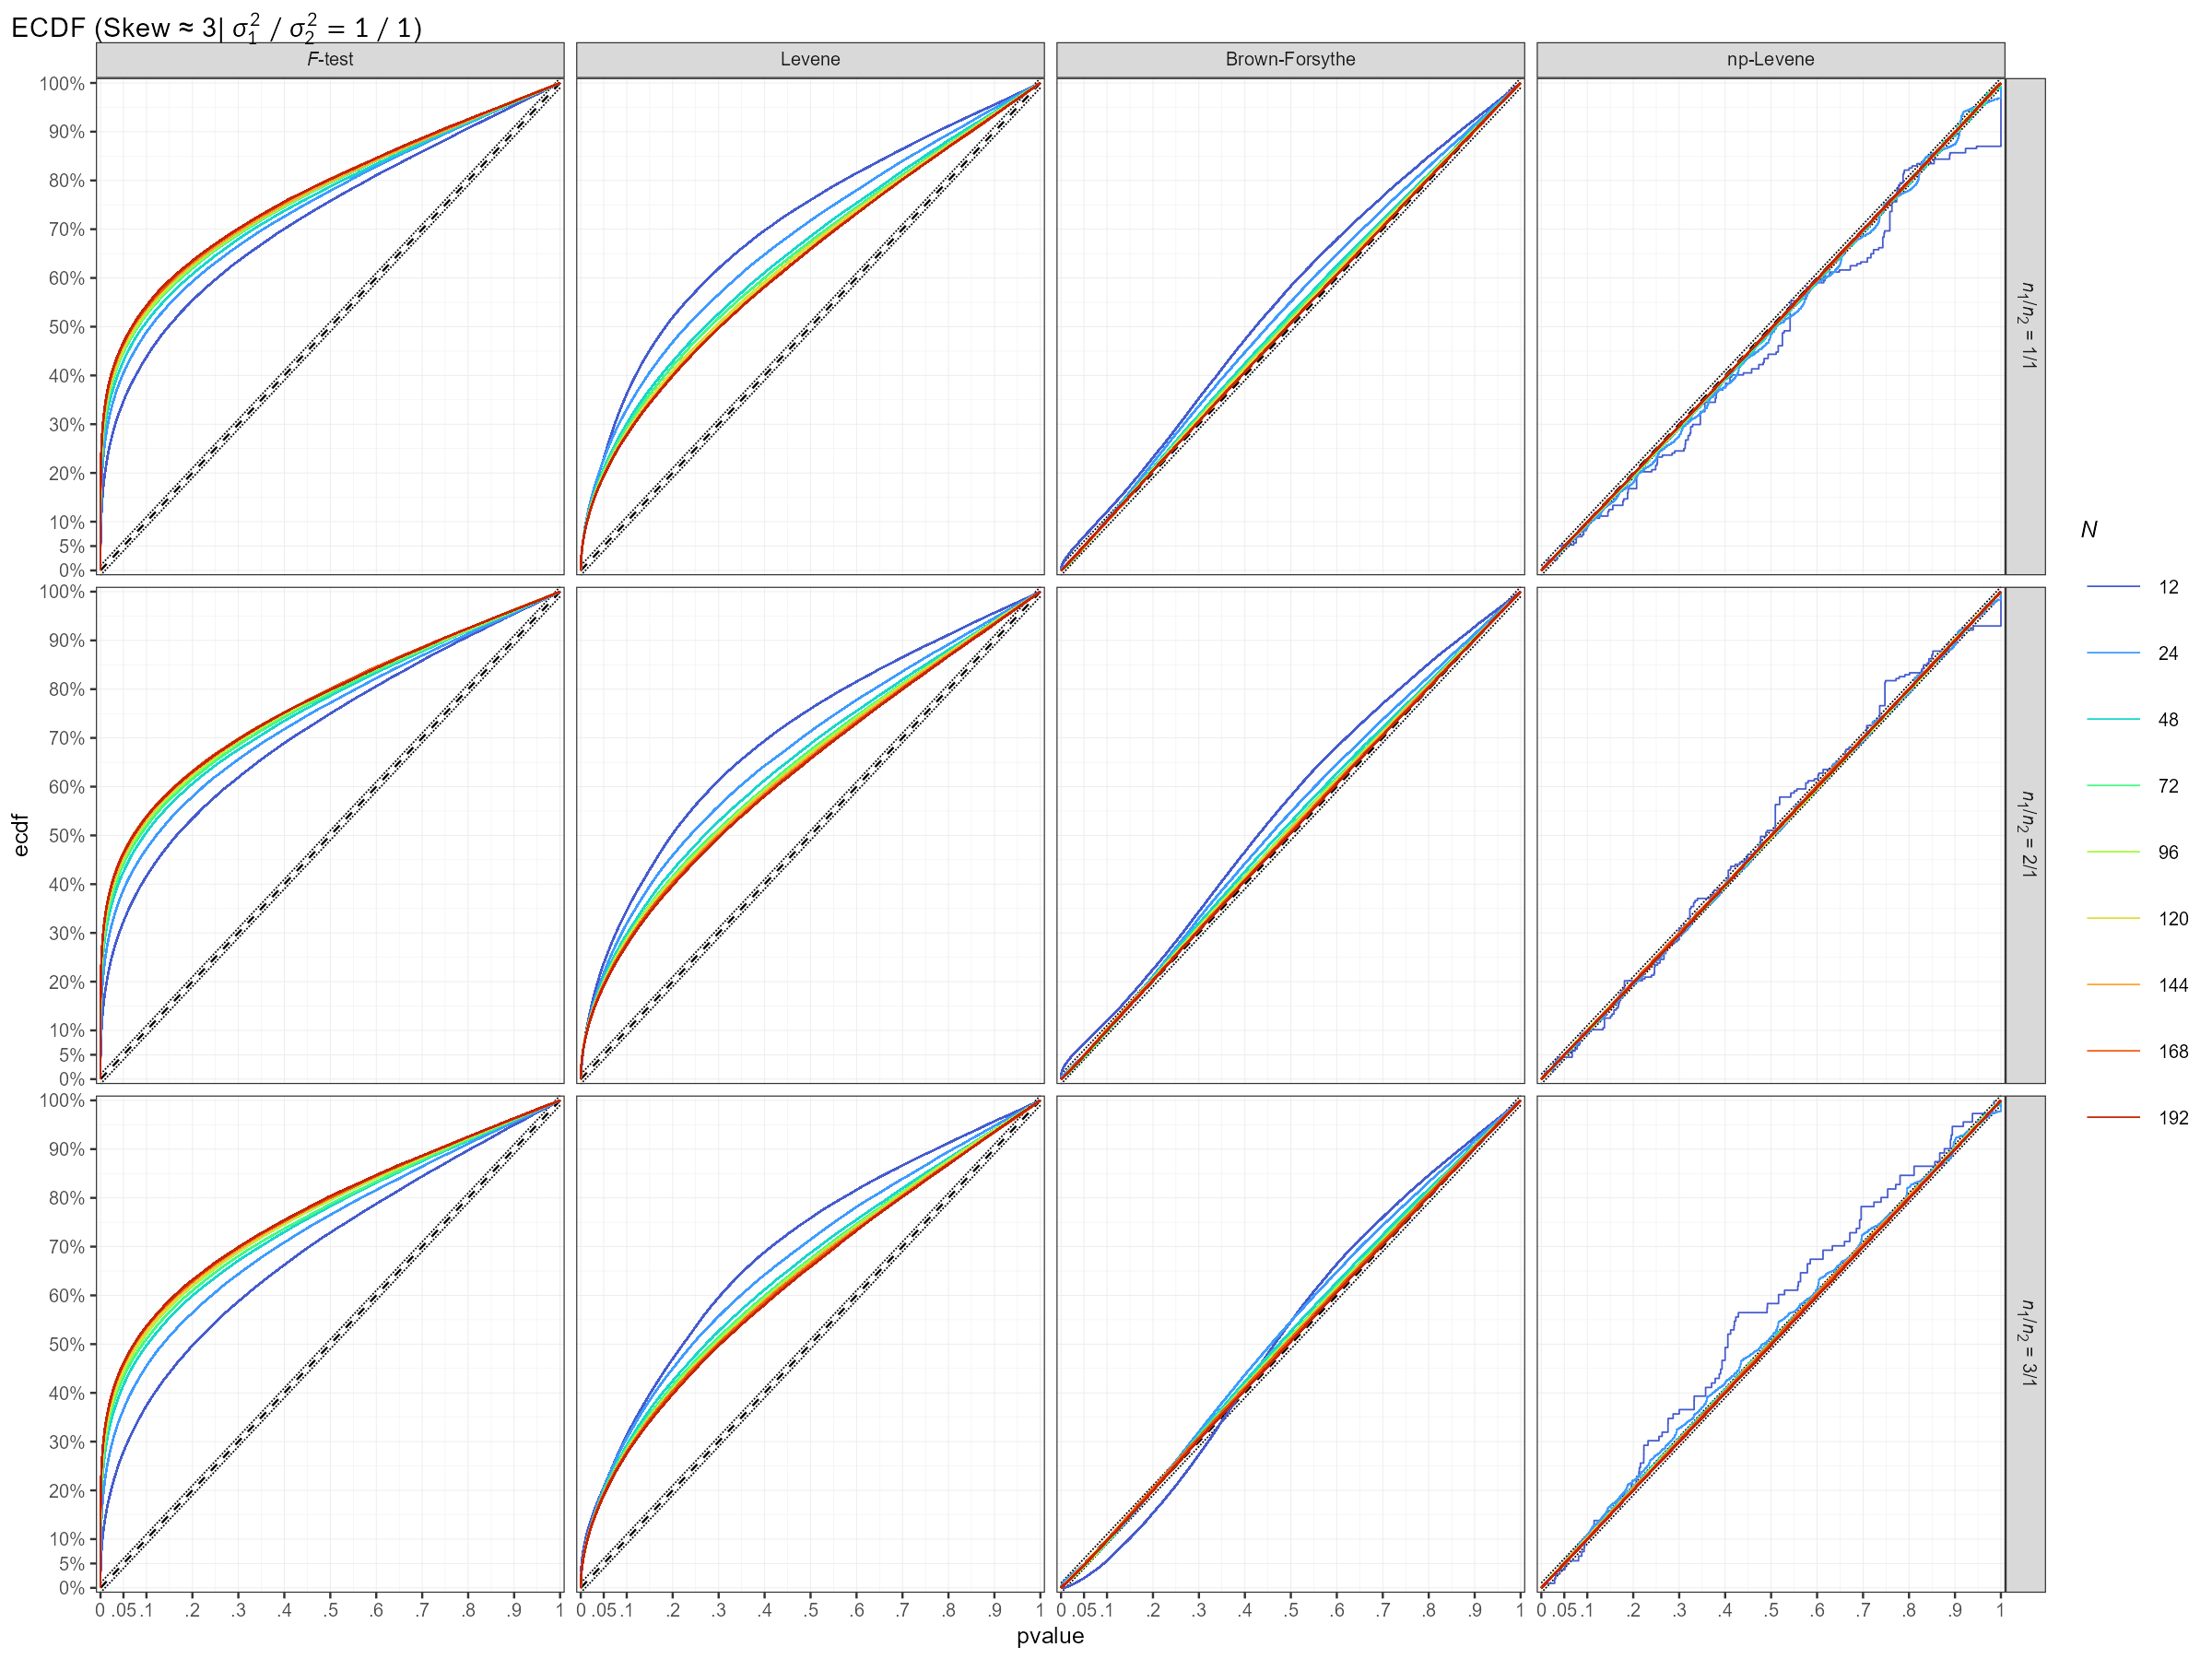
- F検定
- \(Skew \approx 0\)だと問題なさそうですが、\(Skew \gtrapprox 1\)が全然だめです。細かく見ると、総サンプルサイズが大きくなるにつれて小さいp値が多く出ている=type I erro rateがインフレしてます。
- Levene検定
- \(Skew \approx 0\)であっても、総サンプルサイズが小さいときに小さいp値が若干出気味です。\(Skew \gtrapprox 1\)ではダメダメなのはF検定と同じですが、F検定とは反対に総サンプルサイズが大きいほどインフレ度合いは小さいです。
- BF検定
- \(N=12\)の挙動が目立ちますね。小さめのp値は、どの歪度でもサンプルサイズ比\(n_1/n_2=3/1\)でははあまり出ない感じで、\(n_1/n_2=1/1, 2/1\)では歪度が大きくなると出がちでしょうか。全体を通して見ると、歪度が大きくなるにつれて総サンプルサイズが小さいほど中盤当たりのp値が出やすいのかな?といった印象です。一応\(\alpha \leq .2\)くらいまでの基準であれば、名目上のαをおおむね維持できているといっていいかもしれません。(が、きれいに対角線に載っていない以上、気を付けるべきではあります。)
- np-Levene検定
- 歪度よりもサンプルサイズ比の方が影響がありそうな気がします。プロット(=歪度)を見比べてみてもECDFはそれほど変わりませんが、行要素(=サンプルサイズ比)で見比べると違うのがわかるかと思います。とくに\(n_1/n_2=3/1\)では\(N=12\)の条件で中盤当たりのp値が出やすいようなのと、\(N=24\)も若干対角線より上に出ているように見えます。こちらもBF検定と一緒で、一応\(\alpha \leq .2\)くらいまでの基準であれば、名目上のαをおおむね維持できているといっていいかもしれません。
以上をまとめると、type I error rateについては、F検定とLevene検定は分布の歪度が大きくなればなるほど制御できていないという結果が得られました。また、Levene検定については歪度=0のときでも、小サンプルサイズのときではType I error rateが高めに出がちでした。この2手法に比べればBrown-Forsythe検定とnp-Levene検定はマシだといえるでしょう。
Extra: Power
検出力についても、条件が多すぎるのでグラフにします。元論文の”Inverse Pairings”(サンプルサイズが小さい群の母分散が大きい場合)は上段、“Direct Pairings”(サンプルサイズが大きい群の母分散が大きい場合)は下段に、倍数は上下で揃えてあります。
Code
res_summary_df |>
filter(idx_skew == 0) |>
filter_out(var_ratio == "1/1") |>
select(n_total:var_ratio, ends_with("err_05")) |>
pivot_longer(
cols = ends_with("err_05"),
names_to = c("Procedures", ".value"),
names_pattern = "(.+)_(err)_05",
names_transform = list(
Procedures = \(x) as_factor(x)
)
) |>
mutate(
n_ratio = as.factor(n_ratio),
var_ratio = as_factor(var_ratio) |>
fct_relevel(paste0("1/",2:5), paste0(2:5, "/1"))
) |>
ggplot(aes(
x = n_total,
y = err,
group = interaction(n_ratio, Procedures),
color = Procedures,
linetype = n_ratio
)) +
geom_hline(
yintercept = c(.8, .95)
) +
geom_line() +
geom_point(size = .5) +
scale_x_continuous(
name = "Total Sample size <i>N</i>",
breaks = c(12, seq(24, 192, 24)),
minor_breaks = NULL,
expand = expansion(add = 3)
) +
scale_y_continuous(
name = "Empirical Rejection Rate",
breaks = seq(0, 1, .05),
minor_breaks = seq(0, 1, .025),
labels = scales::label_percent(),
expand = expansion(add = .01)
) +
scale_color_discrete(
name = "Procedures",
labels = c(
"ftest" = "*F*-test",
"levene" = "Levene",
"bf" = "Brown-Forsythe",
"nplevene" = "np-Levene"
)
) +
scale_linetype_manual(
name = "n ratio (<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub>)",
values = c("solid", "longdash", "22"),
labels = paste0(1:3, "/1") |>
setNames(nm = 1:3)
) +
facet_wrap(
vars(var_ratio),
nrow = 2,
labeller = labeller(
var_ratio = paste0(
"σ<sub>1</sub><sup>2</sup>/σ<sub>2</sub><sup>2</sup> = ",
unique(df_design$var_ratio)
) |>
setNames(levels(unique(df_design$var_ratio)))
)
) +
labs(title = "Empirical Rejection Rate: Power ($\\alpha = .05$)") +
theme_bw(base_size = 6) +
theme(
plot.title = gridmicrotex::element_markdown(),
plot.title.position = "plot",
axis.title.x = ggtext::element_markdown(),
legend.title = ggtext::element_markdown(),
legend.text = ggtext::element_markdown(),
strip.text = ggtext::element_markdown()
)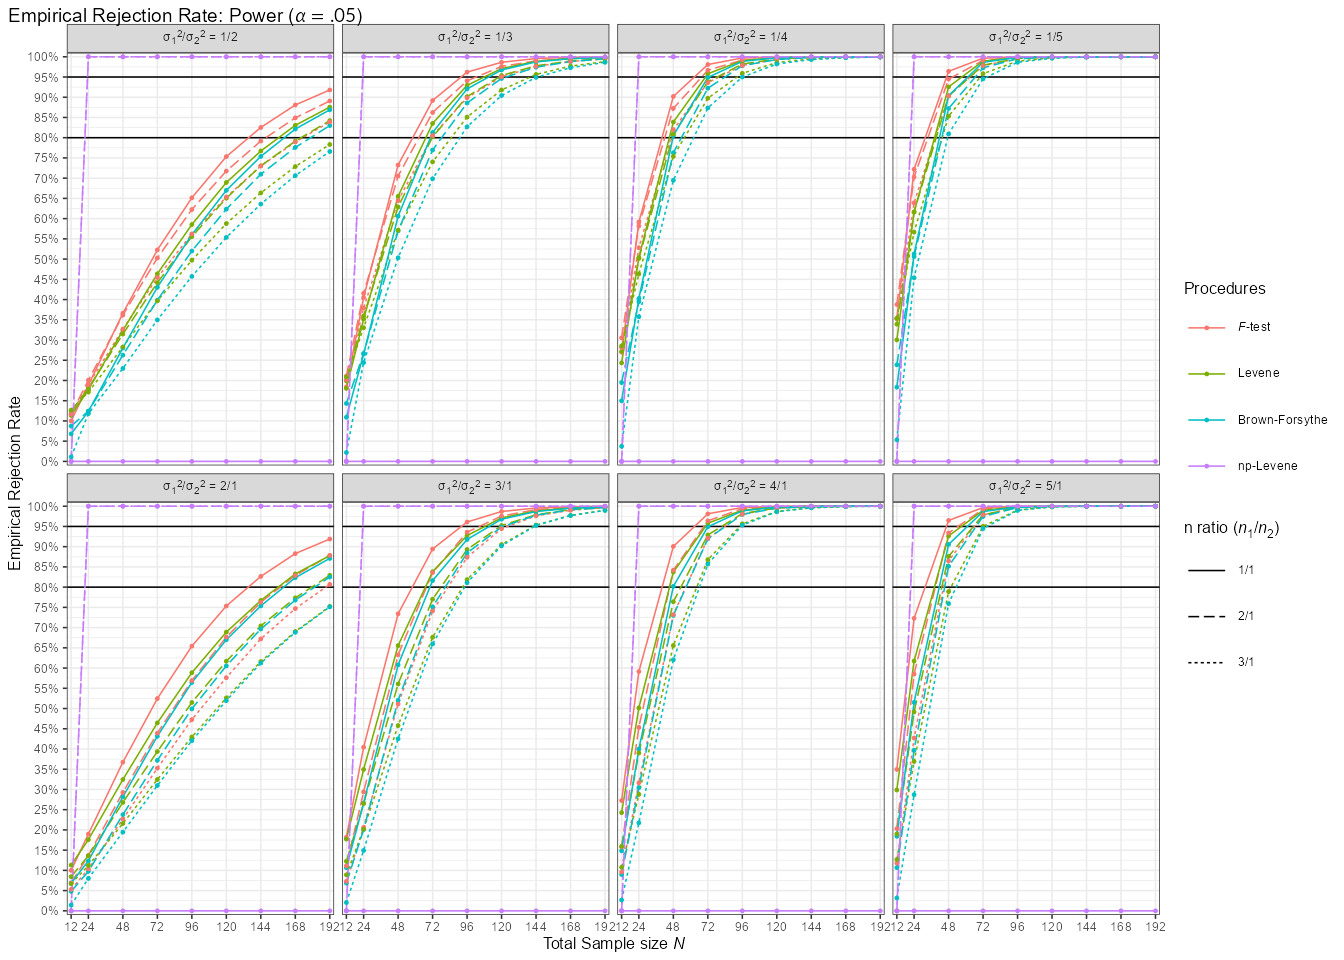
う~ん、Facetを使ってもやっぱり見づらい。とりあえず、普通じゃないのとそうじゃないのの見分けはつきますね。普通じゃないのは置いといて、検出力はF検定>Levene検定>BF検定という形がどの条件でも共通しています。\(N=12\)だとF検定<Levene検定ですが、Levene検定は総サンプルサイズが小さいときは若干type I error がインフレ気味なので、ここだけLevene検定の方がいいとは言い難いですね。あと、サンプルサイズ比の違いで若干違いもあるように見受けられます。
とりあえず、手法もFacetに追加してみましょう。
Code
res_summary_df |>
  filter(idx_skew == 0) |>
  filter_out(var_ratio == "1/1") |>
  select(n_total:var_ratio, ends_with("err_05")) |>
  pivot_longer(
    cols = ends_with("err_05"),
    names_to = c("Procedures", ".value"),
    names_pattern = "(.+)_(err)_05",
    names_transform = list(
      Procedures = \(x) as_factor(x)
    )
  ) |>
  mutate(
    n_ratio = as.factor(n_ratio),
    var_ratio =  as_factor(var_ratio)
  ) |>
  ggplot(aes(
    x = n_total,
    y = err,
    color = var_ratio
  )) +
  geom_hline(
    yintercept = c(.8, .95)
  ) +
  geom_line() +
  geom_point(size = .5) +
  scale_x_continuous(
    name = "Total Sample size <i>N</i>",
    breaks = c(12, seq(24, 192, 24)),
    expand = expansion(add = 3)
  ) +
  scale_y_continuous(
    name = "Empirical Rejection Rate",
    breaks = c(seq(0, .9, .1), .95, 1),
    minor_breaks = seq(0, 1, .05),
    labels = scales::label_percent(),
    expand = expansion(add = .01)
  ) +
  facet_grid(
    rows = vars(Procedures),
    cols = vars(n_ratio),
    labeller = labeller(
      n_ratio = paste0(
        "<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
        1:3, "/1"
      ) |>
        setNames(1:3),
      Procedures = c(
        "ftest" = "*F*-test",
        "levene" = "Levene",
        "bf" = "Brown-Forsythe",
        "nplevene" = "np-Levene"
      )
    )
  ) +
  labs(
    title = "Empirical Rejection Rate: Power ($Skew \\approx 0$ | $\\alpha = .05$)",
    color = "$\\sigma_1^2/\\sigma_2^2$"
  ) +
  theme_bw(base_size = 6) +
  theme(
    plot.title = gridmicrotex::element_markdown(),
    plot.title.position = "plot",
    axis.title.x = ggtext::element_markdown(),
    legend.title = gridmicrotex::element_markdown(),
    strip.text = ggtext::element_markdown()
  )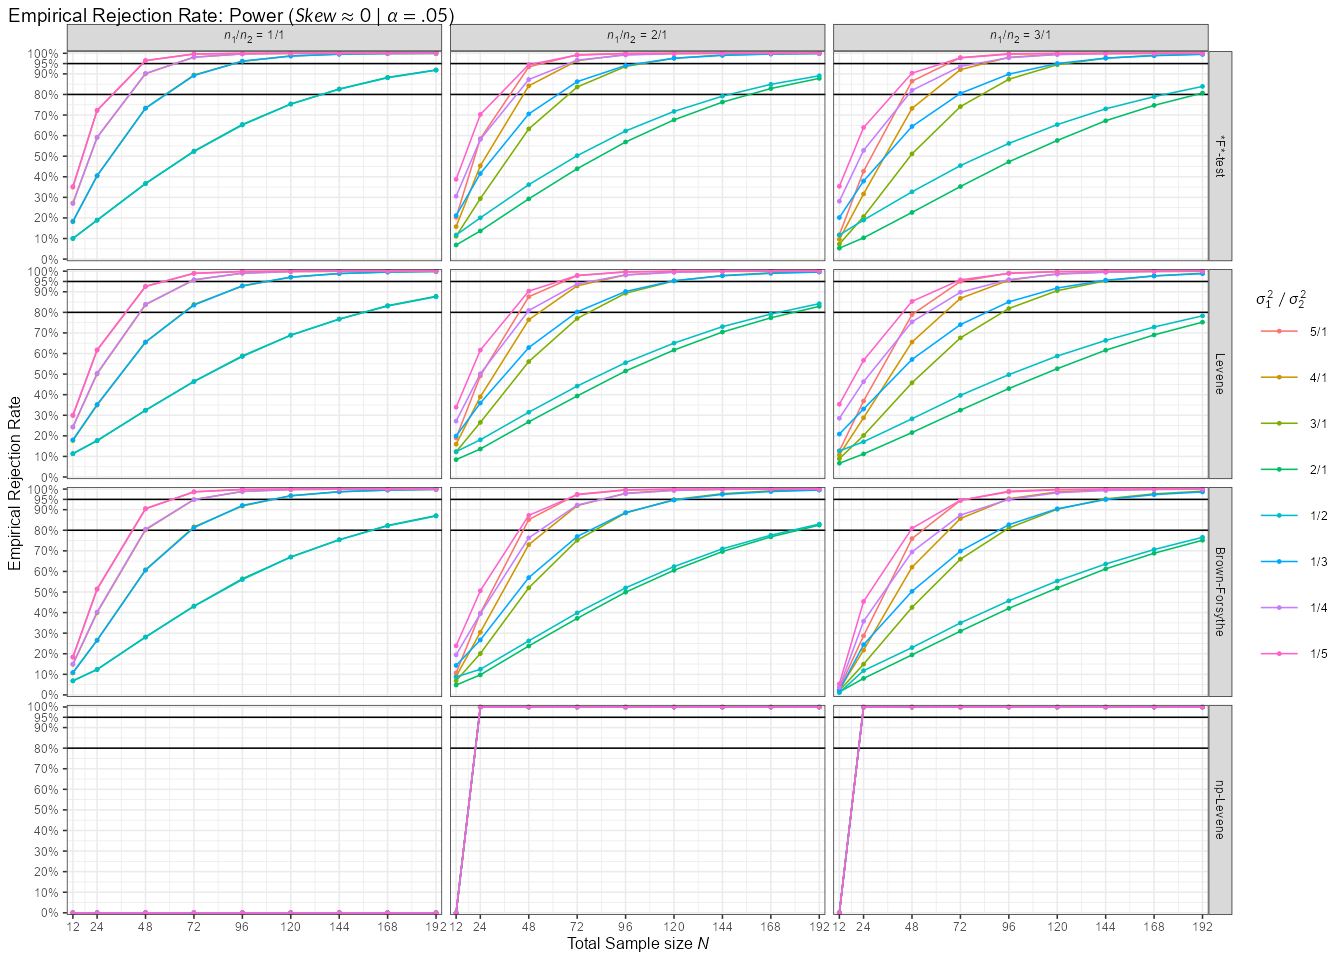
こちらの方が見やすいですね。まず上段の3手法ですが、\(n_1/n_2=1/1\)、つまり2群のサンプルサイズが等しい場合はほとんど線が丸被りしています。よく考えてみれば、等サンプルサイズでは群は置換可能なので当然ですね。\(n_1/n_2\geq2\)と等サンプルサイズでない場合ですが、サンプルサイズが小さい群の分散が大きい条件の方が検出力が高くなっていて、その差は総サンプルサイズが少ないときの方が顕著です。総サンプルサイズが大きくなるにつれて検出力が上がっていき、差は小さくなっていますね。\(Skew\approx0\)の条件なので、正規分布からデータ発生した前の記事の結果と大体同じ感じです。そして母分散比があまり大きくないときに検出力がそれほど高くないのも前回の結果と同じですね。
そして特筆すべきは最下段のnp-Levene検定ですね。\(n_1/n_2=1/1\)の条件全てと、非等サンプルサイズ条件の\(N=12\)のときでは検出力0%、それ以外では逆に検出力100%となりました。まじです。
Code
# A tibble: 27 × 10
   n_total n_ratio `5/1` `4/1` `3/1` `2/1` `1/2` `1/3` `1/4` `1/5`
     <int>   <int> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
 1      12       1     0     0     0     0     0     0     0     0
 2      12       2     0     0     0     0     0     0     0     0
 3      12       3     0     0     0     0     0     0     0     0
 4      24       1     0     0     0     0     0     0     0     0
 5      24       2     1     1     1     1     1     1     1     1
 6      24       3     1     1     1     1     1     1     1     1
 7      48       1     0     0     0     0     0     0     0     0
 8      48       2     1     1     1     1     1     1     1     1
 9      48       3     1     1     1     1     1     1     1     1
10      72       1     0     0     0     0     0     0     0     0
11      72       2     1     1     1     1     1     1     1     1
12      72       3     1     1     1     1     1     1     1     1
13      96       1     0     0     0     0     0     0     0     0
14      96       2     1     1     1     1     1     1     1     1
15      96       3     1     1     1     1     1     1     1     1
16     120       1     0     0     0     0     0     0     0     0
17     120       2     1     1     1     1     1     1     1     1
18     120       3     1     1     1     1     1     1     1     1
19     144       1     0     0     0     0     0     0     0     0
20     144       2     1     1     1     1     1     1     1     1
21     144       3     1     1     1     1     1     1     1     1
22     168       1     0     0     0     0     0     0     0     0
23     168       2     1     1     1     1     1     1     1     1
24     168       3     1     1     1     1     1     1     1     1
25     192       1     0     0     0     0     0     0     0     0
26     192       2     1     1     1     1     1     1     1     1
27 192 3 1 1 1 1 1 1 1 1検出力100%と聞くと素晴らしい気もしますが、\(n_1/n_2=1\)の条件は完全に0なのでむしろダメダメです。最初見たときにはすごく驚いたのですが、よくよく考えてみるとからくりがあることに気づきました。試しにこんな条件で簡単にシミュレーションを回してみます(10000回)。標準正規分布から、総サンプルサイズ\(N=192\)でデータを発生させて、サンプルサイズ比は\(n_1/n_2=2/1\)にします。ただし、わかりやすさのために群1の平均値は3までずらしておきます。群1と群2は平均値が異なるだけで母分散は全く変わらないです。そのため、ここでのrejectionはType I errorになります。
set.seed(20260917)
rbind(
  matrix(rnorm(128 * 1e4, mean = 3, sd = 1), ncol = 1e4),
  matrix(rnorm(64 * 1e4, mean = 0, sd = 1), ncol = 1e4)
) |>
  Rfast::colRanks() |>
  matrixTests::col_levene(g = list_vec_group[["192_2"]]) |>
  simhelpers::calc_rejection(
    p_values = pvalue,
    alpha = c(.05, .01)
  ) |>
  relocate(ends_with("05"), .after = 1)
K_rejection rej_rate_05 rej_rate_mcse_05 rej_rate_01 rej_rate_mcse_01
1 10000 1 0 1 0はい、rej_rateが1なのでType I error rate = 100%です。分散は同じはずなのに平均値が違うだけで異分散だと判断するのはまずいですね。これの原因は、サンプルサイズが等しくない場合に平均値があまりにも違いすぎると、順位変換した時に群1と群2の順位が確実に離れてまとまることで、サンプルサイズが大きい方の群では順位の分散が大きくなってしまうことによります (Shear et al., 2018) 。等分散性の検定は複数群の分散が等しいかどうかを判定したいために行う検定なので、平均値が離れているかどうかに反応してくれなくていいのです。しかし、np-Levene検定の場合は群間の分布の位置にも大きく影響を受けてしまいます。この点に関しては、元論文の著者たちが後年に複数の平均値差、中心化の基準(平均値、中央値)なども条件に入れたモンテカルロシミュレーションを行って確認していて、結局BF検定の方が望ましいと主張しています (Shear et al., 2018) 。
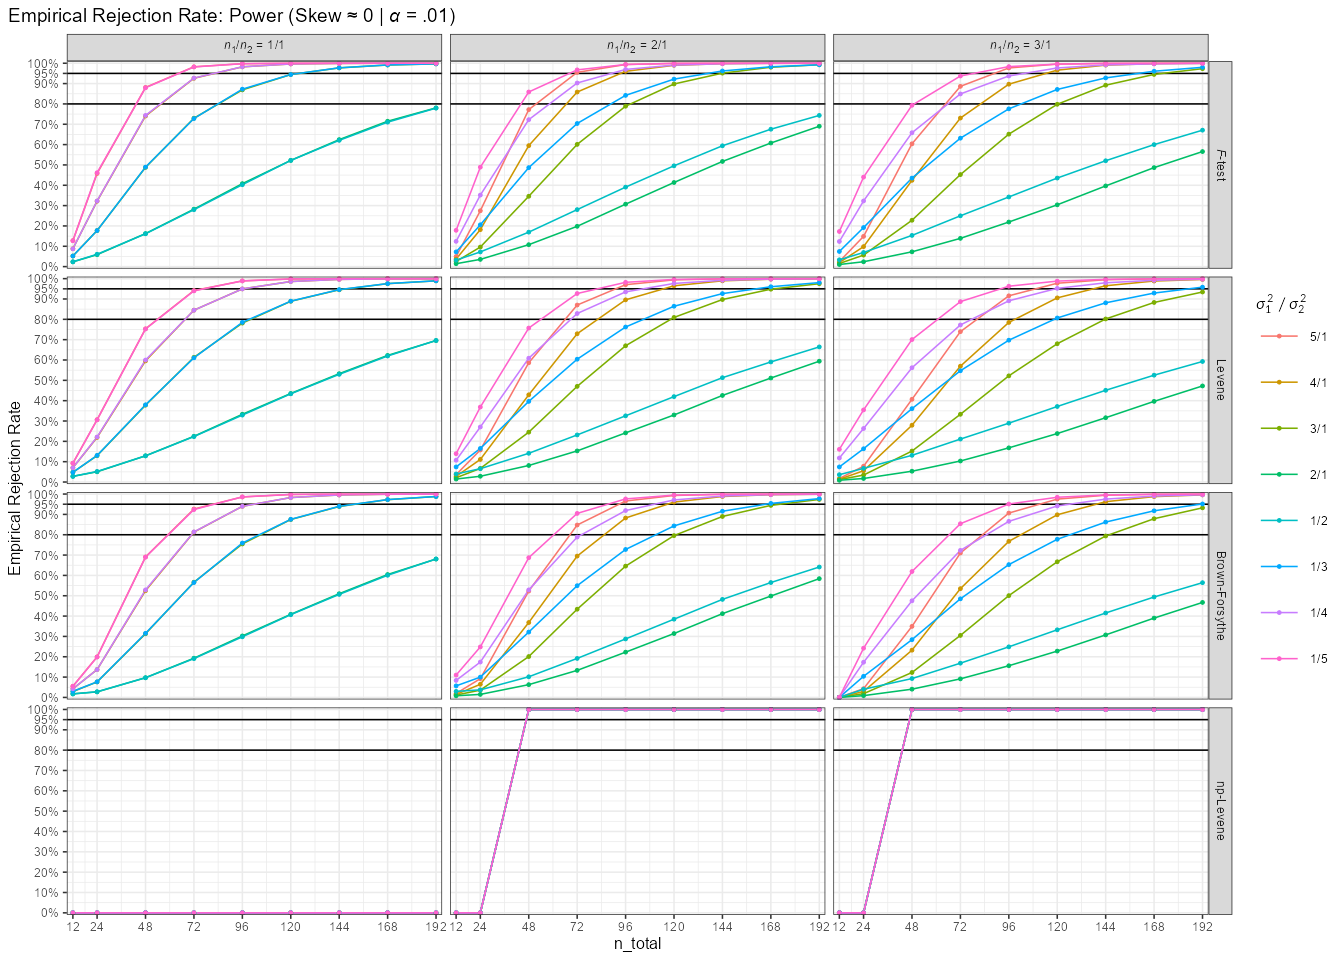
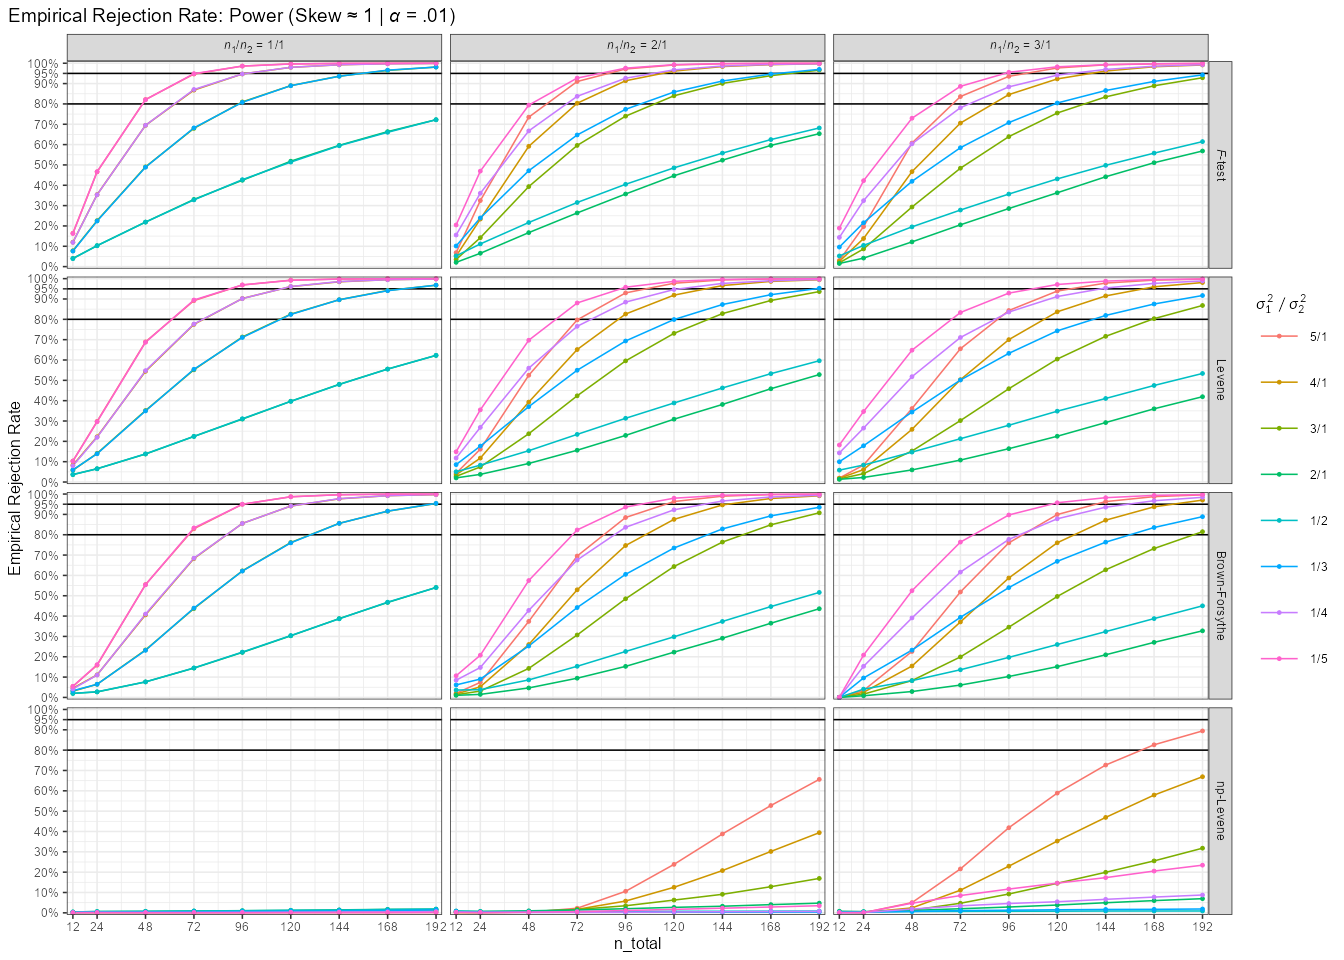
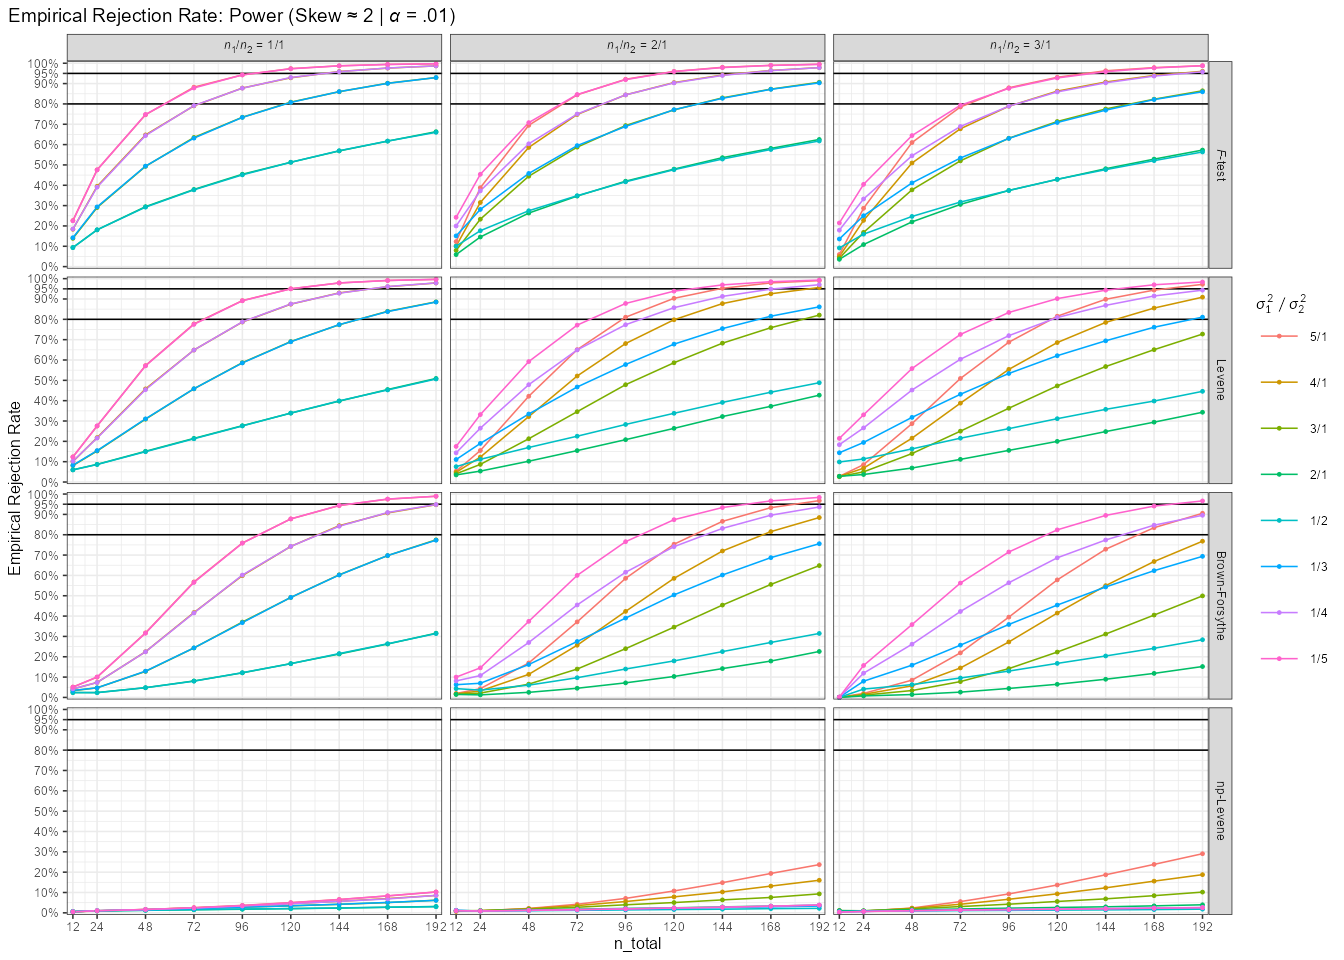
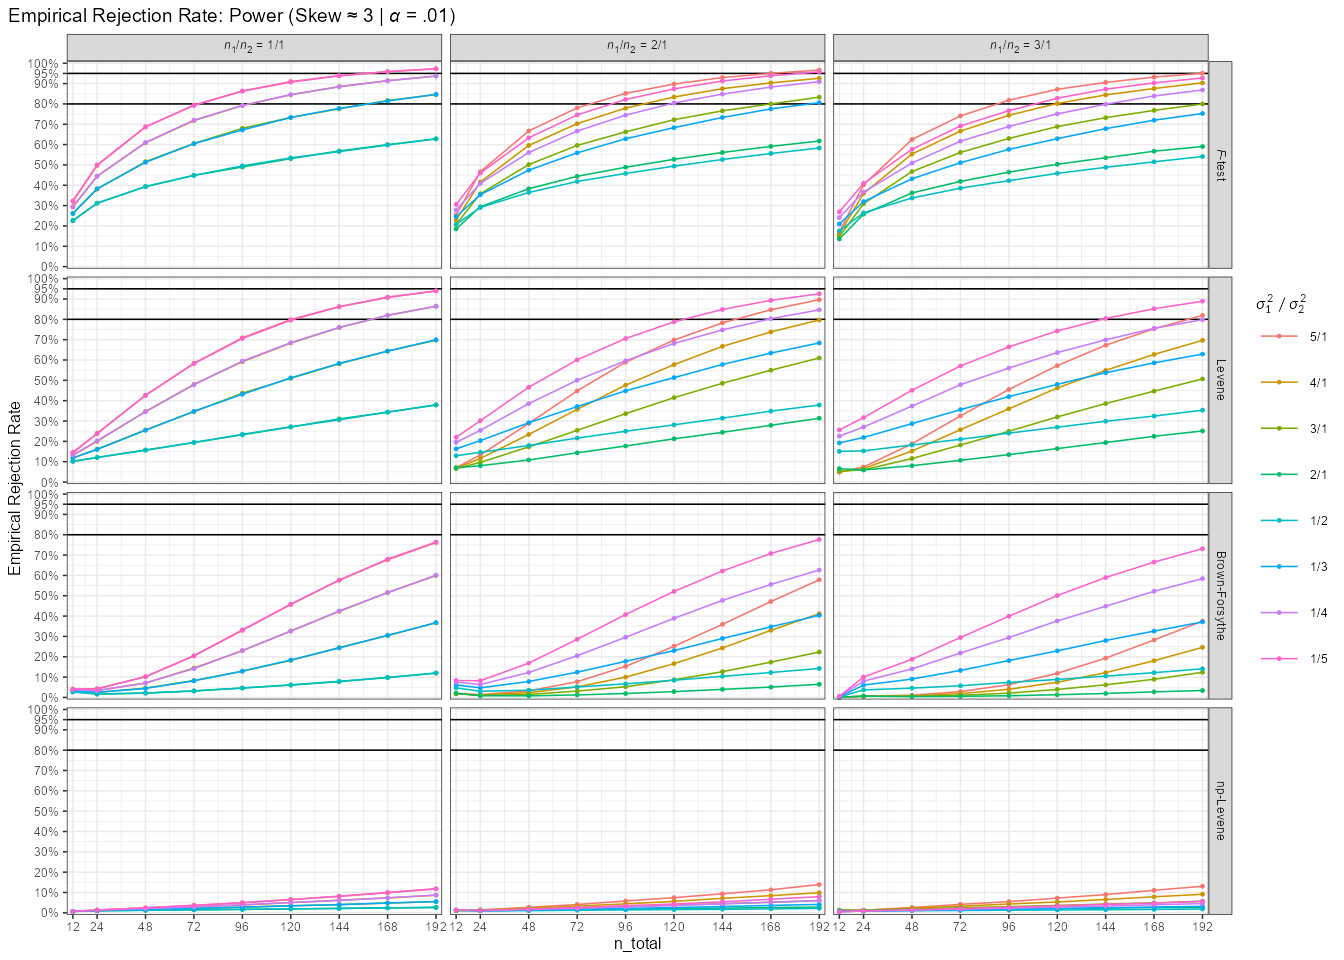
参考として、\(Skew \gtrapprox 1\)の条件の検出力も見ておきます。せっかくなので全ての検定を載せておきます。
Code
res_summary_df |>
filter_out(var_ratio == "1/1" | idx_skew == 0) |>
select(idx_skew:var_ratio, ends_with("err_05")) |>
pivot_longer(
cols = ends_with("err_05"),
names_to = c("Procedures", ".value"),
names_pattern = "(.+)_(err)_05",
names_transform = list(
Procedures = \(x) as_factor(x)
)
) |>
mutate(
n_ratio = as.factor(n_ratio),
var_ratio = as_factor(var_ratio)
) |>
group_by(idx_skew) |>
group_map(
.f = \(x, idx) {
x |>
ggplot(aes(
x = n_total,
y = err,
color = var_ratio
)) +
geom_hline(
yintercept = c(.8, .95)
) +
geom_line() +
geom_point(size = .5) +
scale_x_continuous(
breaks = c(12, seq(24, 192, 24)),
expand = expansion(add = 3)
) +
scale_y_continuous(
name = "Empirical Rejection Rate",
limits = c(0, 1),
breaks = c(seq(0, .9, .1), .95, 1),
minor_breaks = seq(0, 1, .05),
labels = scales::label_percent(),
expand = expansion(add = .01)
) +
facet_grid(
rows = vars(Procedures),
cols = vars(n_ratio),
labeller = labeller(
n_ratio = paste0(
"<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
1:3, "/1"
) |>
setNames(1:3),
Procedures = c(
"ftest" = "*F*-test",
"levene" = "Levene",
"bf" = "Brown-Forsythe",
"nplevene" = "np-Levene"
)
)
) +
labs(
title = paste0(
"Empirical Rejection Rate: Power (Skew \u2248 ",
idx$idx_skew,
" | <i>α</i> = .05)"
),
color = "$\\sigma_1^2/\\sigma_2^2$"
) +
theme_bw(base_size = 6) +
theme(
plot.title.position = "plot",
plot.title = ggtext::element_markdown(),
legend.title = gridmicrotex::element_markdown(),
strip.text.x = ggtext::element_markdown(),
strip.text.y = ggtext::element_markdown()
)
}
)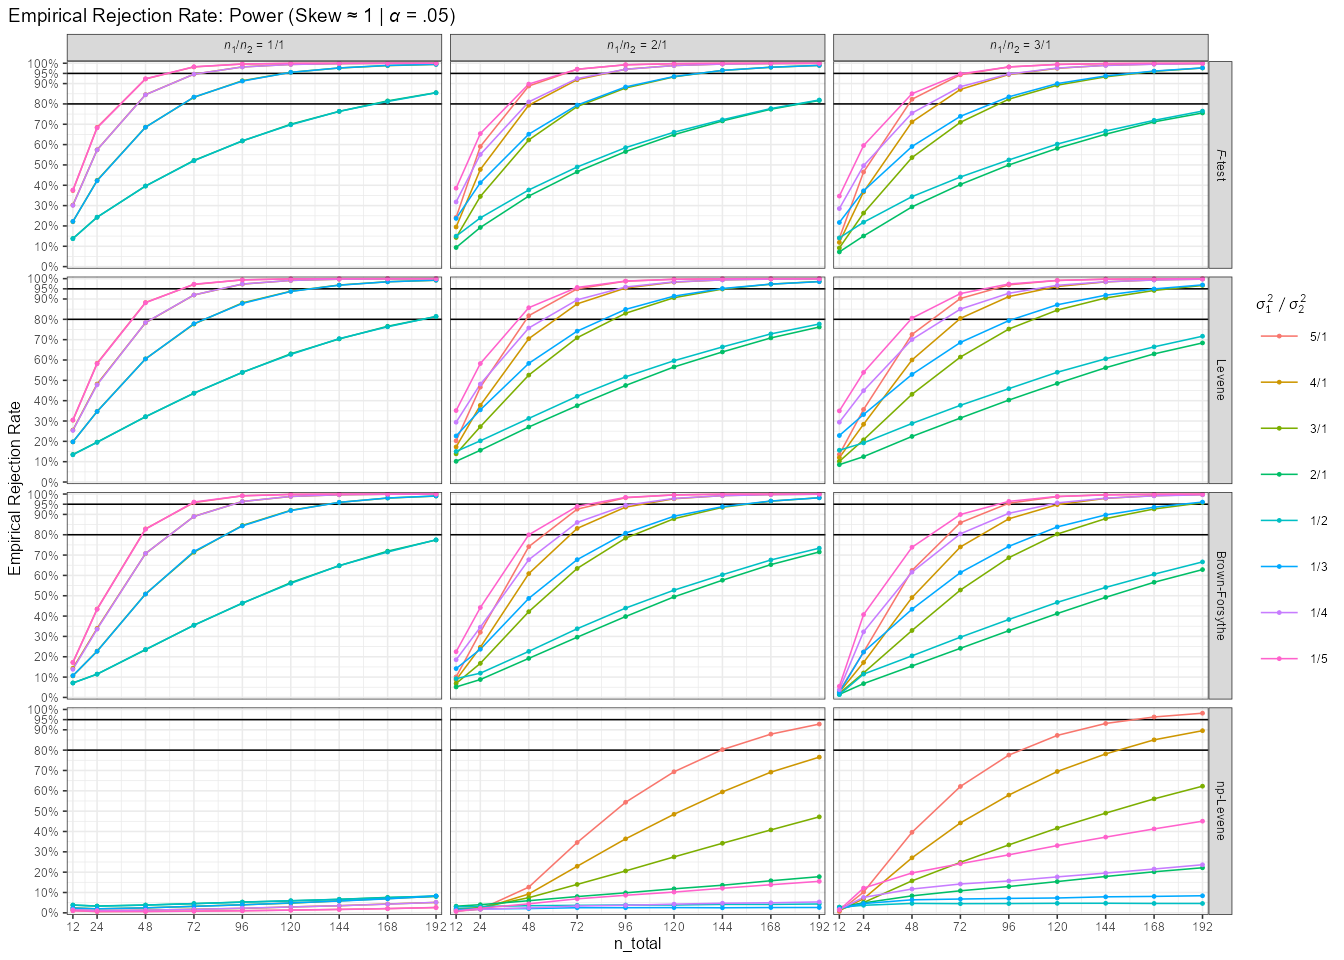
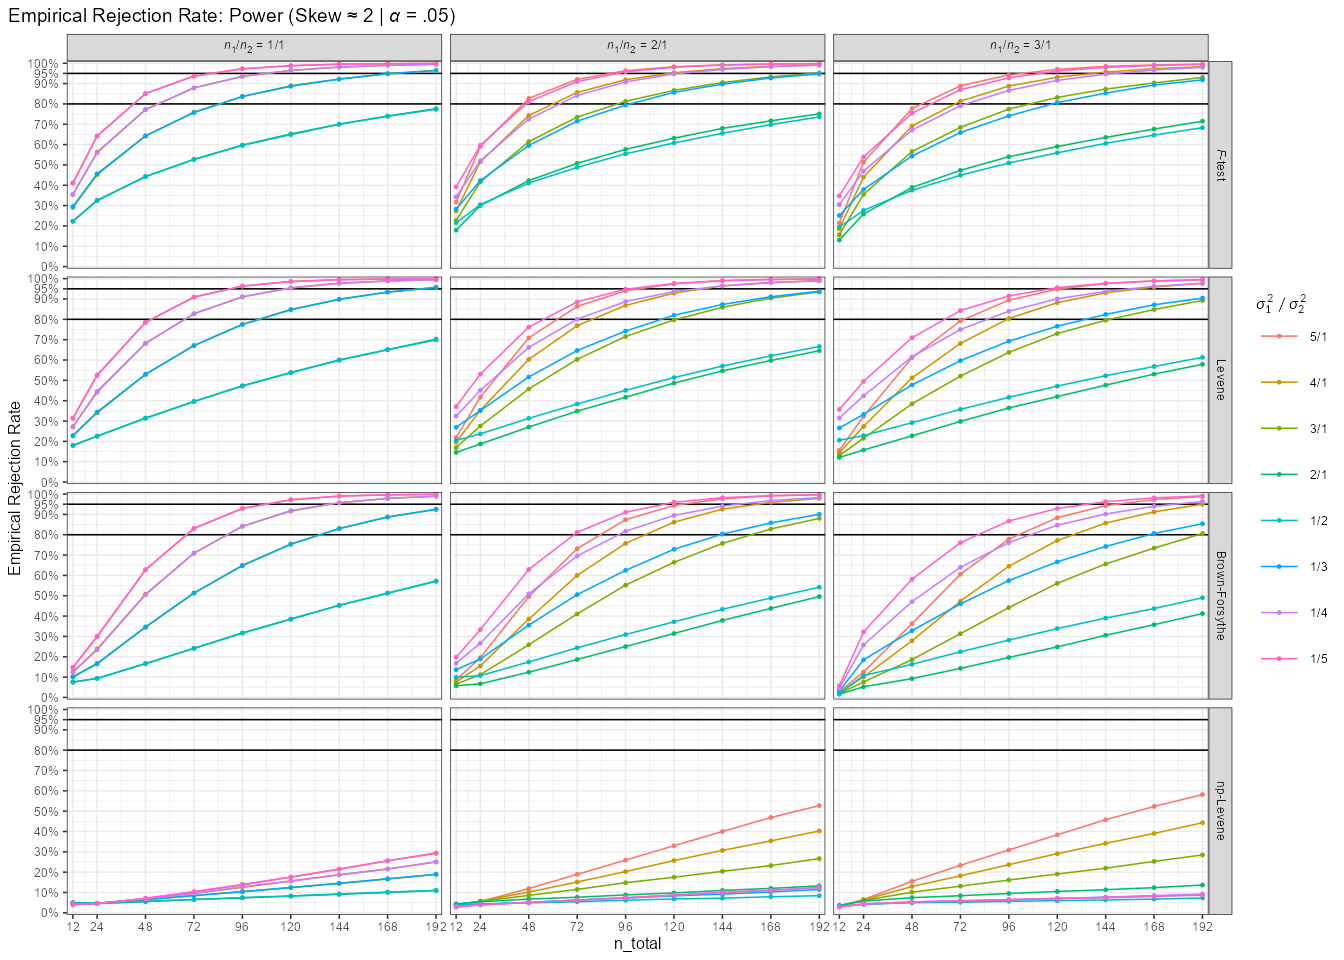
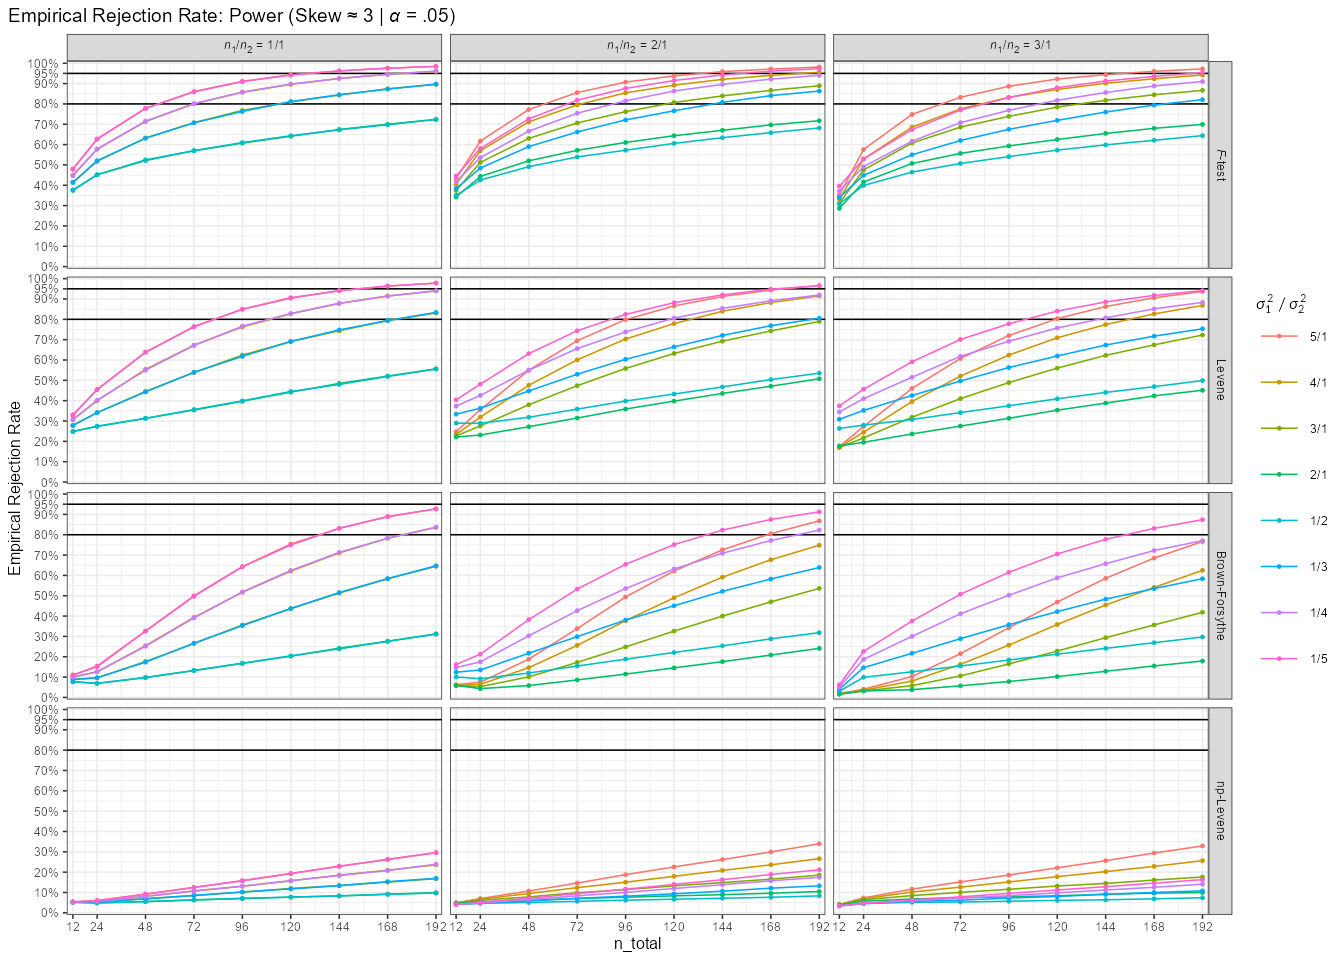
これまでの結果を踏まえてBF検定の結果だけに言及したいと思います。総サンプルサイズを固定して見てみると、歪度が大きくなるにつれて検出力が低くなっています。言い換えれば、歪度が大きいと必要な検出力を確保するための総サンプルサイズを大きくする必要があるということです。例えば、等サンプルサイズ条件で母分散比が\(2/1, 1/2\)の場合、\(Skew \approx1\)では\(N=192\)で80%に届きそうですが、\(Skew \approx 2\)の場合で約60%、\(Skew \approx 3\)の場合では30%程度まで低下しています。前回のシミュレーションでは歪度をいじっていなかったので、これは勉強になりますね。
サンプルサイズ比と母分散比の関係ですが、等サンプルサイズ条件が一番検出力が高くなりました。そして非等サンプルサイズ条件では、Inverse PairingとDirect Pairingを比較すると前者の方が後者よりも検出力が高くなっていました。つまり、サンプルサイズが小さい群の分散が大きいときの方が検出力が高いということです。この点については前回のシミュレーションでも同じような結果が得られています。検出力の差は歪度が大きくなるにつれて大きくなっているように見受けられます。
こうする方が見やすいかも?
Code
res_summary_df |>
  select(idx_skew:var_ratio, bf = bf_err_05) |>
  filter_out(var_ratio == "1/1") |>
  mutate(
    plot_group = case_when(
      n_total < 50 ~ "$N=12, 24, 48$",
      n_total < 140 ~ "$N=72, 96, 120$",
      .default = "$N=144, 168, 192$"
    ) |>
      as_factor(),
    across(
      .cols = c(idx_skew, n_total, n_ratio),
      .fns = \(x) as.factor(x)
    ),
    size_ratio = case_when(
      var_ratio %in% paste0(5:2, "/1") ~ "direct",
      var_ratio %in% paste0("1/", 5:2) ~ "inverse",
    ),
    var_ratio = as_factor(var_ratio)
  ) |>
  group_by(plot_group) |>
  group_map(
    .f = \(x, idx) {
      x |>
        ggplot(aes(
          x = var_ratio,
          y = bf,
          group = interaction(n_ratio, size_ratio),
          color = n_ratio
        )) +
        geom_vline(
          xintercept = "2/1",
          linetype = "dashed",
          position = position_nudge(x = .5)
        ) +
        annotate(
          geom = "text",
          x = "3/1",
          y = .5,
          label = "Direct\nPairing",
          alpha = .1,
          vjust = .5,
          size = 4
        ) +
        annotate(
          geom = "text",
          x = "1/3",
          y = .5,
          label = "Inverse\nPairing",
          alpha = .1,
          vjust = .5,
          size = 4
        ) +
        geom_line() +
        geom_point(size = .5) +
        scale_x_discrete(
          name = "$\\sigma_1^2/\\sigma_2^2$",
          expand = expansion(add = .05)
        ) +
        scale_y_continuous(
          name = "Empirical Rejection Rate",
          limits = c(0, 1),
          breaks = c(0, .05, seq(.1, 1, .1)),
          minor_breaks = seq(.15, 1, .1),
          labels = scales::label_percent(),
          expand = expansion(add = c(0, .01))
        ) +
        scale_color_discrete(
          name = "<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub>",
          labels = c(
            "1" = "1/1",
            "2" = "2/1",
            "3" = "3/1"
          )
        ) +
        facet_grid(
          rows = vars(idx_skew),
          cols = vars(n_total),
          labeller = labeller(
            idx_skew = paste0(
              "Skew \u2248 ",
              0:3
            ) |>
              setNames(nm = 0:3),
            n_total = paste0(
              "*N* = ",
              c(12L, seq(24L, 192L, 24L))
            ) |>
              setNames(nm = c(12L, seq(24L, 192L, 24L))),
          )
        ) +
        labs(
          title = "Empirical Rejection Rate (Power | $\\alpha = .05$): Brown-Forsythe test",
          subtitle = as.character(idx$plot_group)
        ) +
        theme_bw(base_size = 6) +
        theme(
          plot.title = gridmicrotex::element_markdown(),
          plot.title.position = "plot",
          plot.subtitle = gridmicrotex::element_markdown(),
          axis.title.x = gridmicrotex::element_markdown(),
          legend.title = ggtext::element_markdown(),
          legend.position = "top",
          legend.box.spacing = unit(1, units = "pt"),
          strip.text.x = ggtext::element_markdown()
        )
    }
  )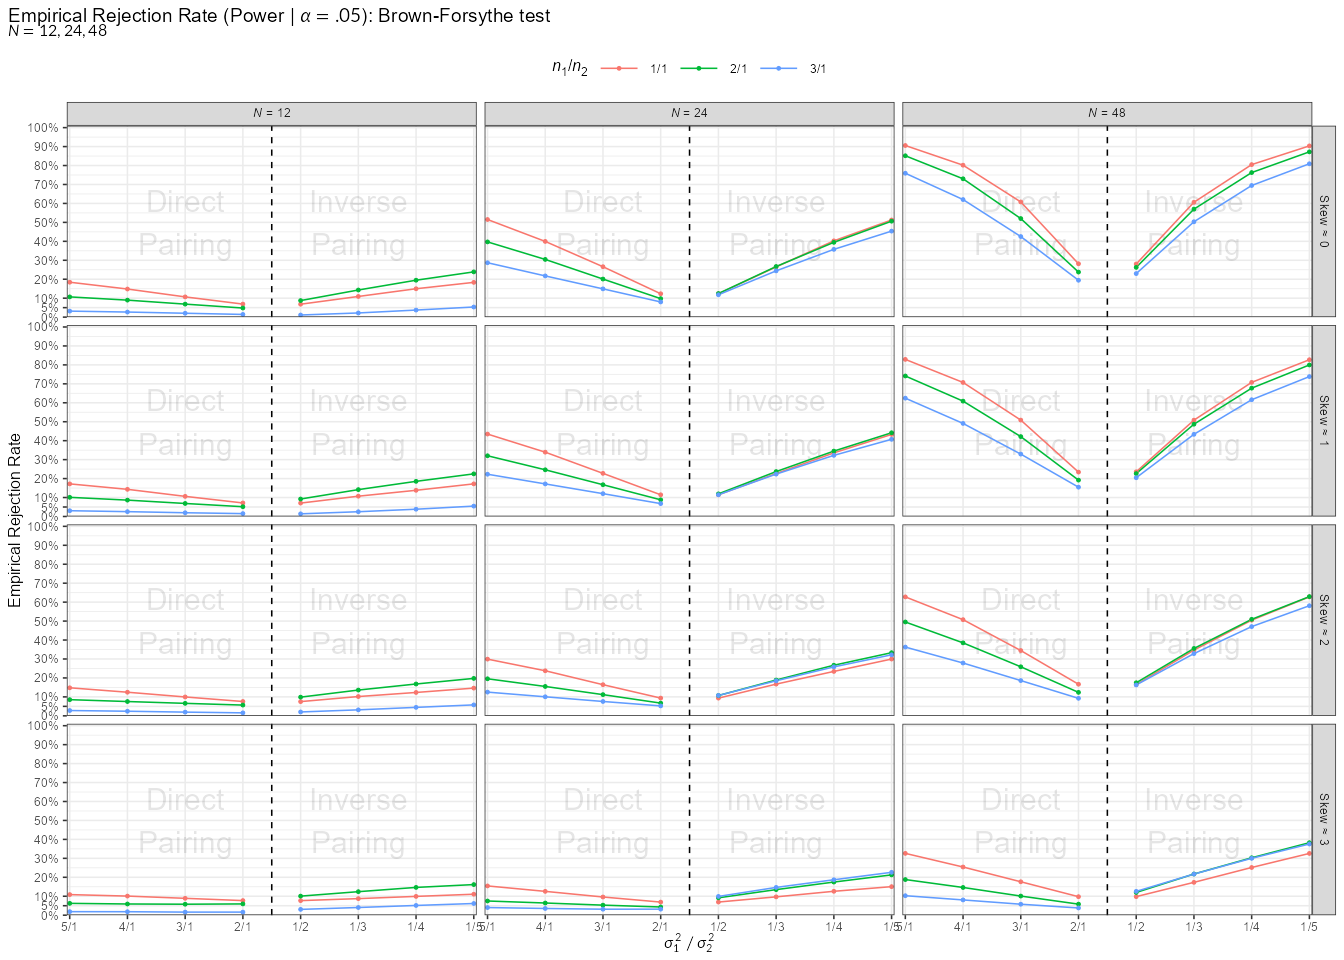
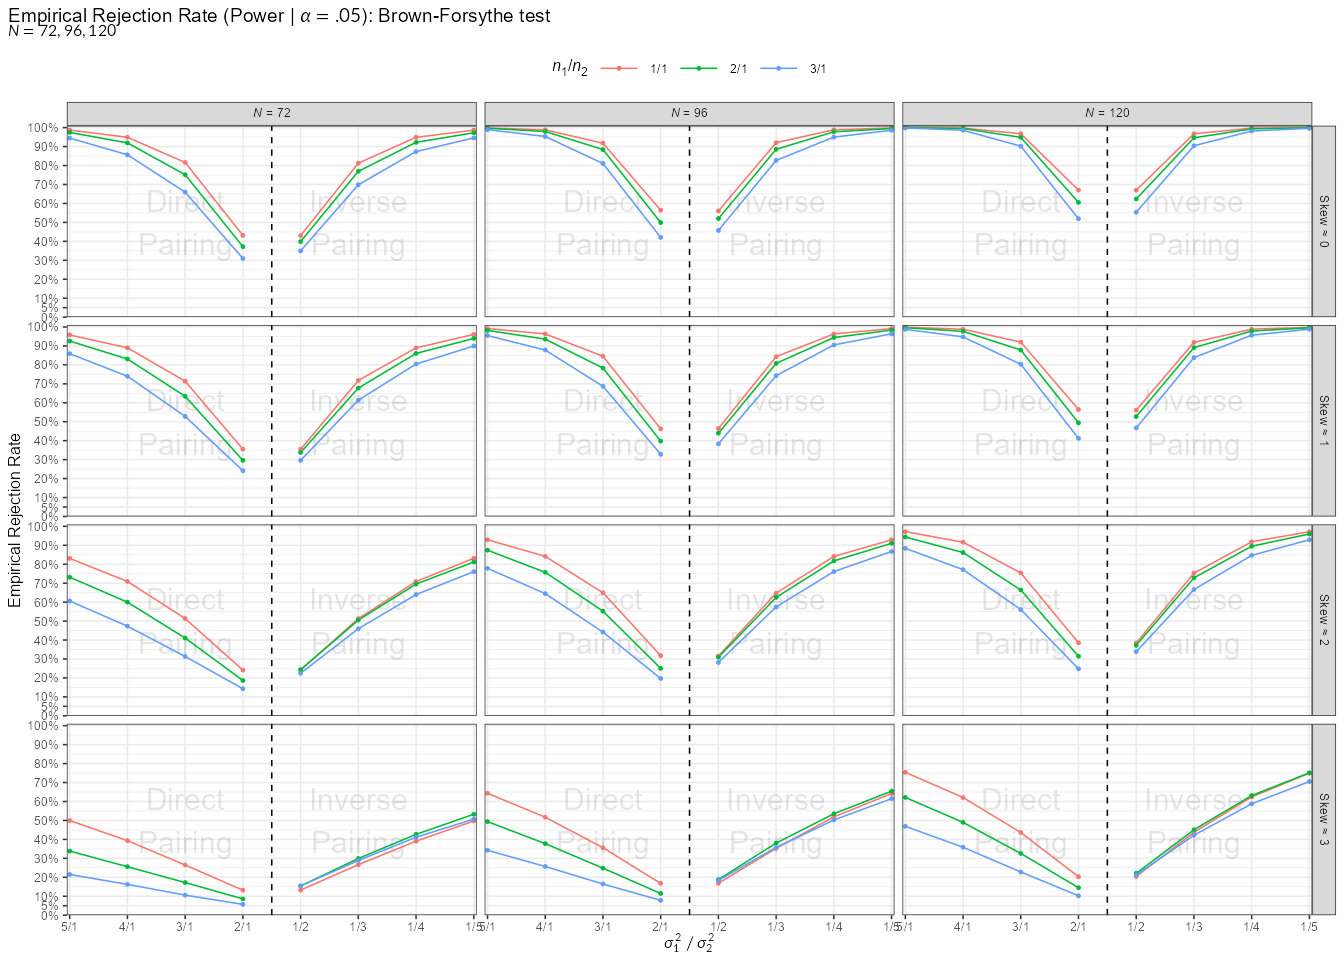
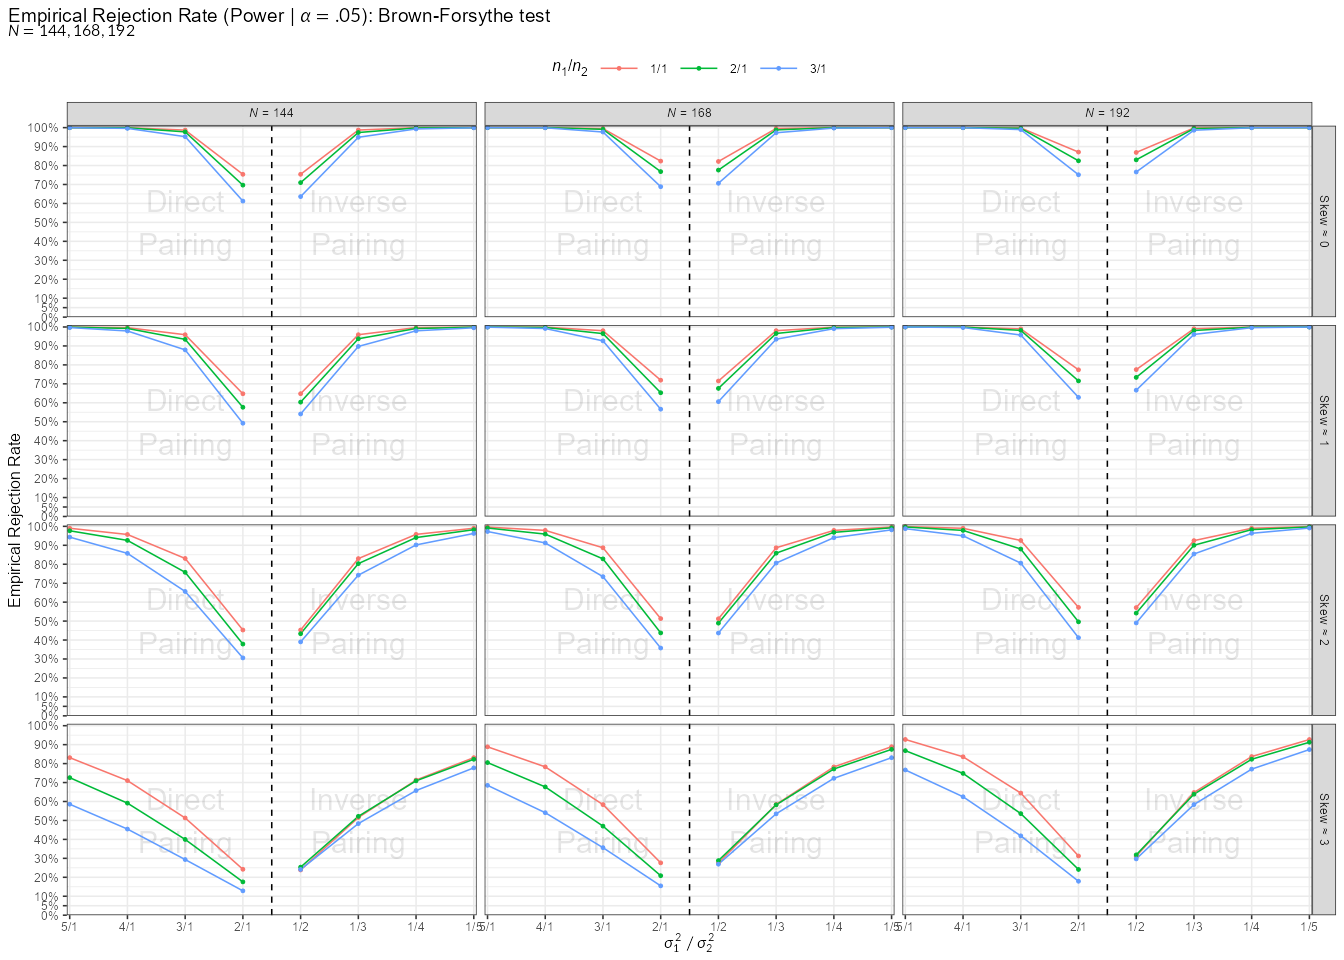
総サンプルサイズで比較すると、大きくなるにつれて検出力が高くなっているのがわかりますね。同じ母分散比で比較すると、歪度が小さい方が検出力が高くなっています。また、同じサンプルサイズ比・同じ母分散の倍数で比較すると、Inverse Pairingの方が検出力が高いことがわかります。
\(\alpha=.01\)の場合も見ておきます。\(\alpha = .05\)と比べて基本的に検出力が落ちているように見受けられます。厳しい基準にしているから当然な気もしますが。
Code
res_summary_df |>
filter_out(var_ratio == "1/1") |>
select(idx_skew:var_ratio, ends_with("err_01")) |>
pivot_longer(
cols = ends_with("err_01"),
names_to = c("Procedures", ".value"),
names_pattern = "(.+)_(err)_01",
names_transform = list(
Procedures = \(x) as_factor(x)
)
) |>
mutate(
n_ratio = as.factor(n_ratio),
var_ratio = as_factor(var_ratio)
) |>
group_by(idx_skew) |>
group_map(
.f = \(x, idx) {
x |>
ggplot(aes(
x = n_total,
y = err,
color = var_ratio
)) +
geom_hline(
yintercept = c(.8, .95)
) +
geom_line() +
geom_point(size = .5) +
scale_x_continuous(
breaks = c(12, seq(24, 192, 24)),
expand = expansion(add = 3)
) +
scale_y_continuous(
name = "Empirical Rejection Rate",
limits = c(0, 1),
breaks = c(seq(0, .9, .1), .95, 1),
minor_breaks = seq(0, 1, .05),
labels = scales::label_percent(),
expand = expansion(add = .01)
) +
facet_grid(
rows = vars(Procedures),
cols = vars(n_ratio),
labeller = labeller(
n_ratio = paste0(
"<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
1:3, "/1"
) |>
setNames(1:3),
Procedures = c(
"ftest" = "*F*-test",
"levene" = "Levene",
"bf" = "Brown-Forsythe",
"nplevene" = "np-Levene"
)
)
) +
labs(
title = paste0(
"Empirical Rejection Rate: Power (Skew \u2248 ",
idx$idx_skew,
" | <i>α</i> = .01)"
),
color = "$\\sigma_1^2/\\sigma_2^2$"
) +
theme_bw(base_size = 6) +
theme(
plot.title.position = "plot",
plot.title = ggtext::element_markdown(),
legend.title = gridmicrotex::element_markdown(),
strip.text.x = ggtext::element_markdown(),
strip.text.y = ggtext::element_markdown()
)
}
)
BF検定だけECDFを出しておきます。画像クリックで拡大できます。元論文のTable 2に合わせて、左半分がInverse Pairing、右半分がDirect Pairingです。
Code
duckplyr::read_parquet_duckdb(path_sim_res) |>
select(idx_skew:var_ratio, bf) |>
filter_out(var_ratio == "1/1") |>
duckplyr::as_duckdb_tibble() |>
mutate(
var_ratio = factor(
var_ratio,
levels = c(
paste0("1/", 5:2),
paste0(2:5, "/1")
)
),
n_total = as.factor(n_total)
) |>
group_by(idx_skew) |>
group_walk(
.f = \(x, idx) {
temp_plot <- x |>
ggplot(aes(
x = bf,
group = n_total,
color = n_total
)) +
annotate(
geom = "segment",
x = 0, xend = 1,
y = 0, yend = 1,
linetype = "dashed"
) +
stat_ecdf(
pad = FALSE,
linewidth = .2
) +
scale_color_viridis_d(
begin = .1,
end = .9,
option = "turbo"
) +
scale_x_continuous(
breaks = c(0, .05, seq(.1, 1, .1)),
minor_breaks = seq(.15, 1, .1),
labels = c(0, .05, seq(.1, 1, .1)) |>
format() |>
gsub("(\\.*0+$|^0(?!\\.00))", replacement = "", x = _, perl = TRUE),
expand = expansion(add = .01)
) +
scale_y_continuous(
breaks = seq(0, 1, .1),
labels = scales::label_percent(),
expand = expansion(add = .01)
) +
facet_grid(
rows = vars(n_ratio),
cols = vars(var_ratio),
labeller = labeller(
n_ratio = paste0(
"<i>n</i><sub>1</sub>/<i>n</i><sub>2</sub> = ",
1:3, "/1"
) |>
setNames(1:3),
var_ratio = paste0(
"σ<sub>1</sub><sup>2</sup>/σ<sub>2</sub><sup>2</sup> = ",
unique(df_design$var_ratio)
) |>
setNames(levels(unique(df_design$var_ratio)))
)
) +
labs(
title = paste0(
"ECDF of Brown-Forsythe test ",
"($\\sigma_1^2 \\ne \\sigma_2^2$ | Skew \u2248 ",
idx$idx_skew,
")"
),
x = "pvalue",
color = "*N*"
) +
theme_bw(base_size = 6) +
theme(
plot.title = gridmicrotex::element_markdown(),
plot.title.position = "plot",
panel.grid = element_line(linewidth = .1),
legend.title = ggtext::element_markdown(),
strip.text.x = ggtext::element_markdown(),
strip.text.y = ggtext::element_markdown()
)
ggsave(
paste0(
"rep_nordstokke_zumbo_2007_power_ecdf_skew",
idx$idx_skew,
".png"
),
plot = temp_plot,
width = 12
)
}
)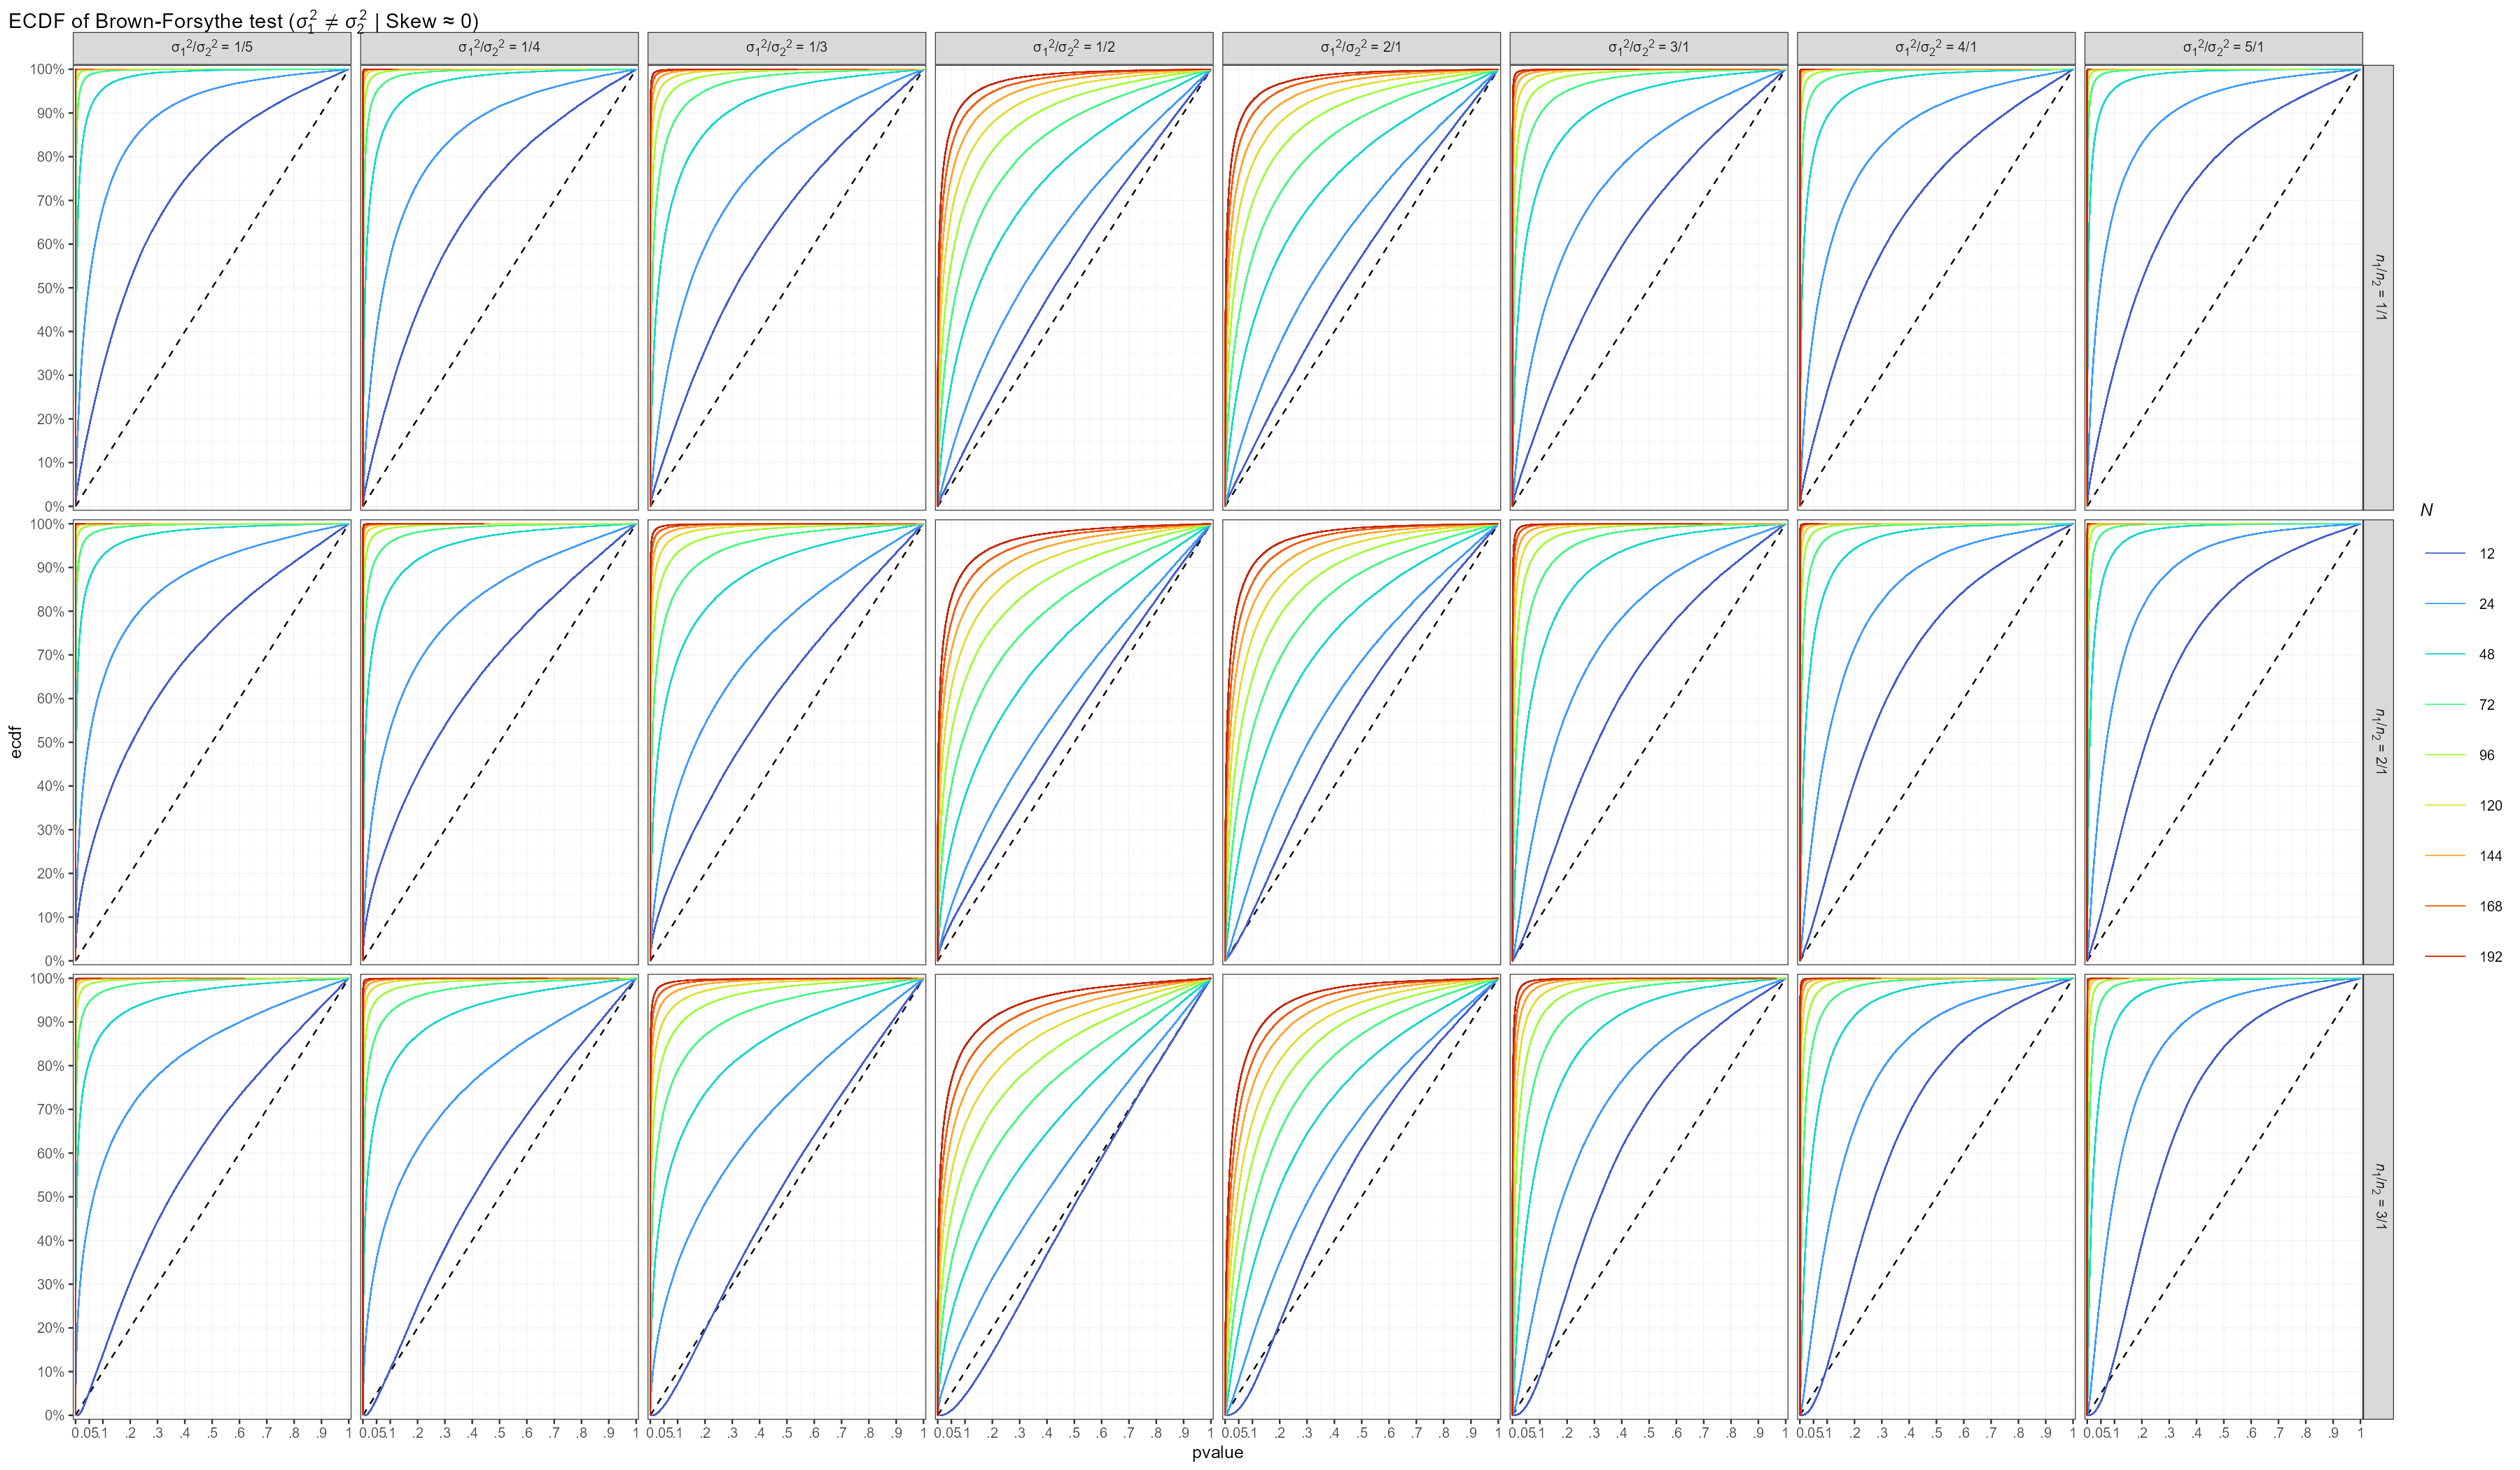
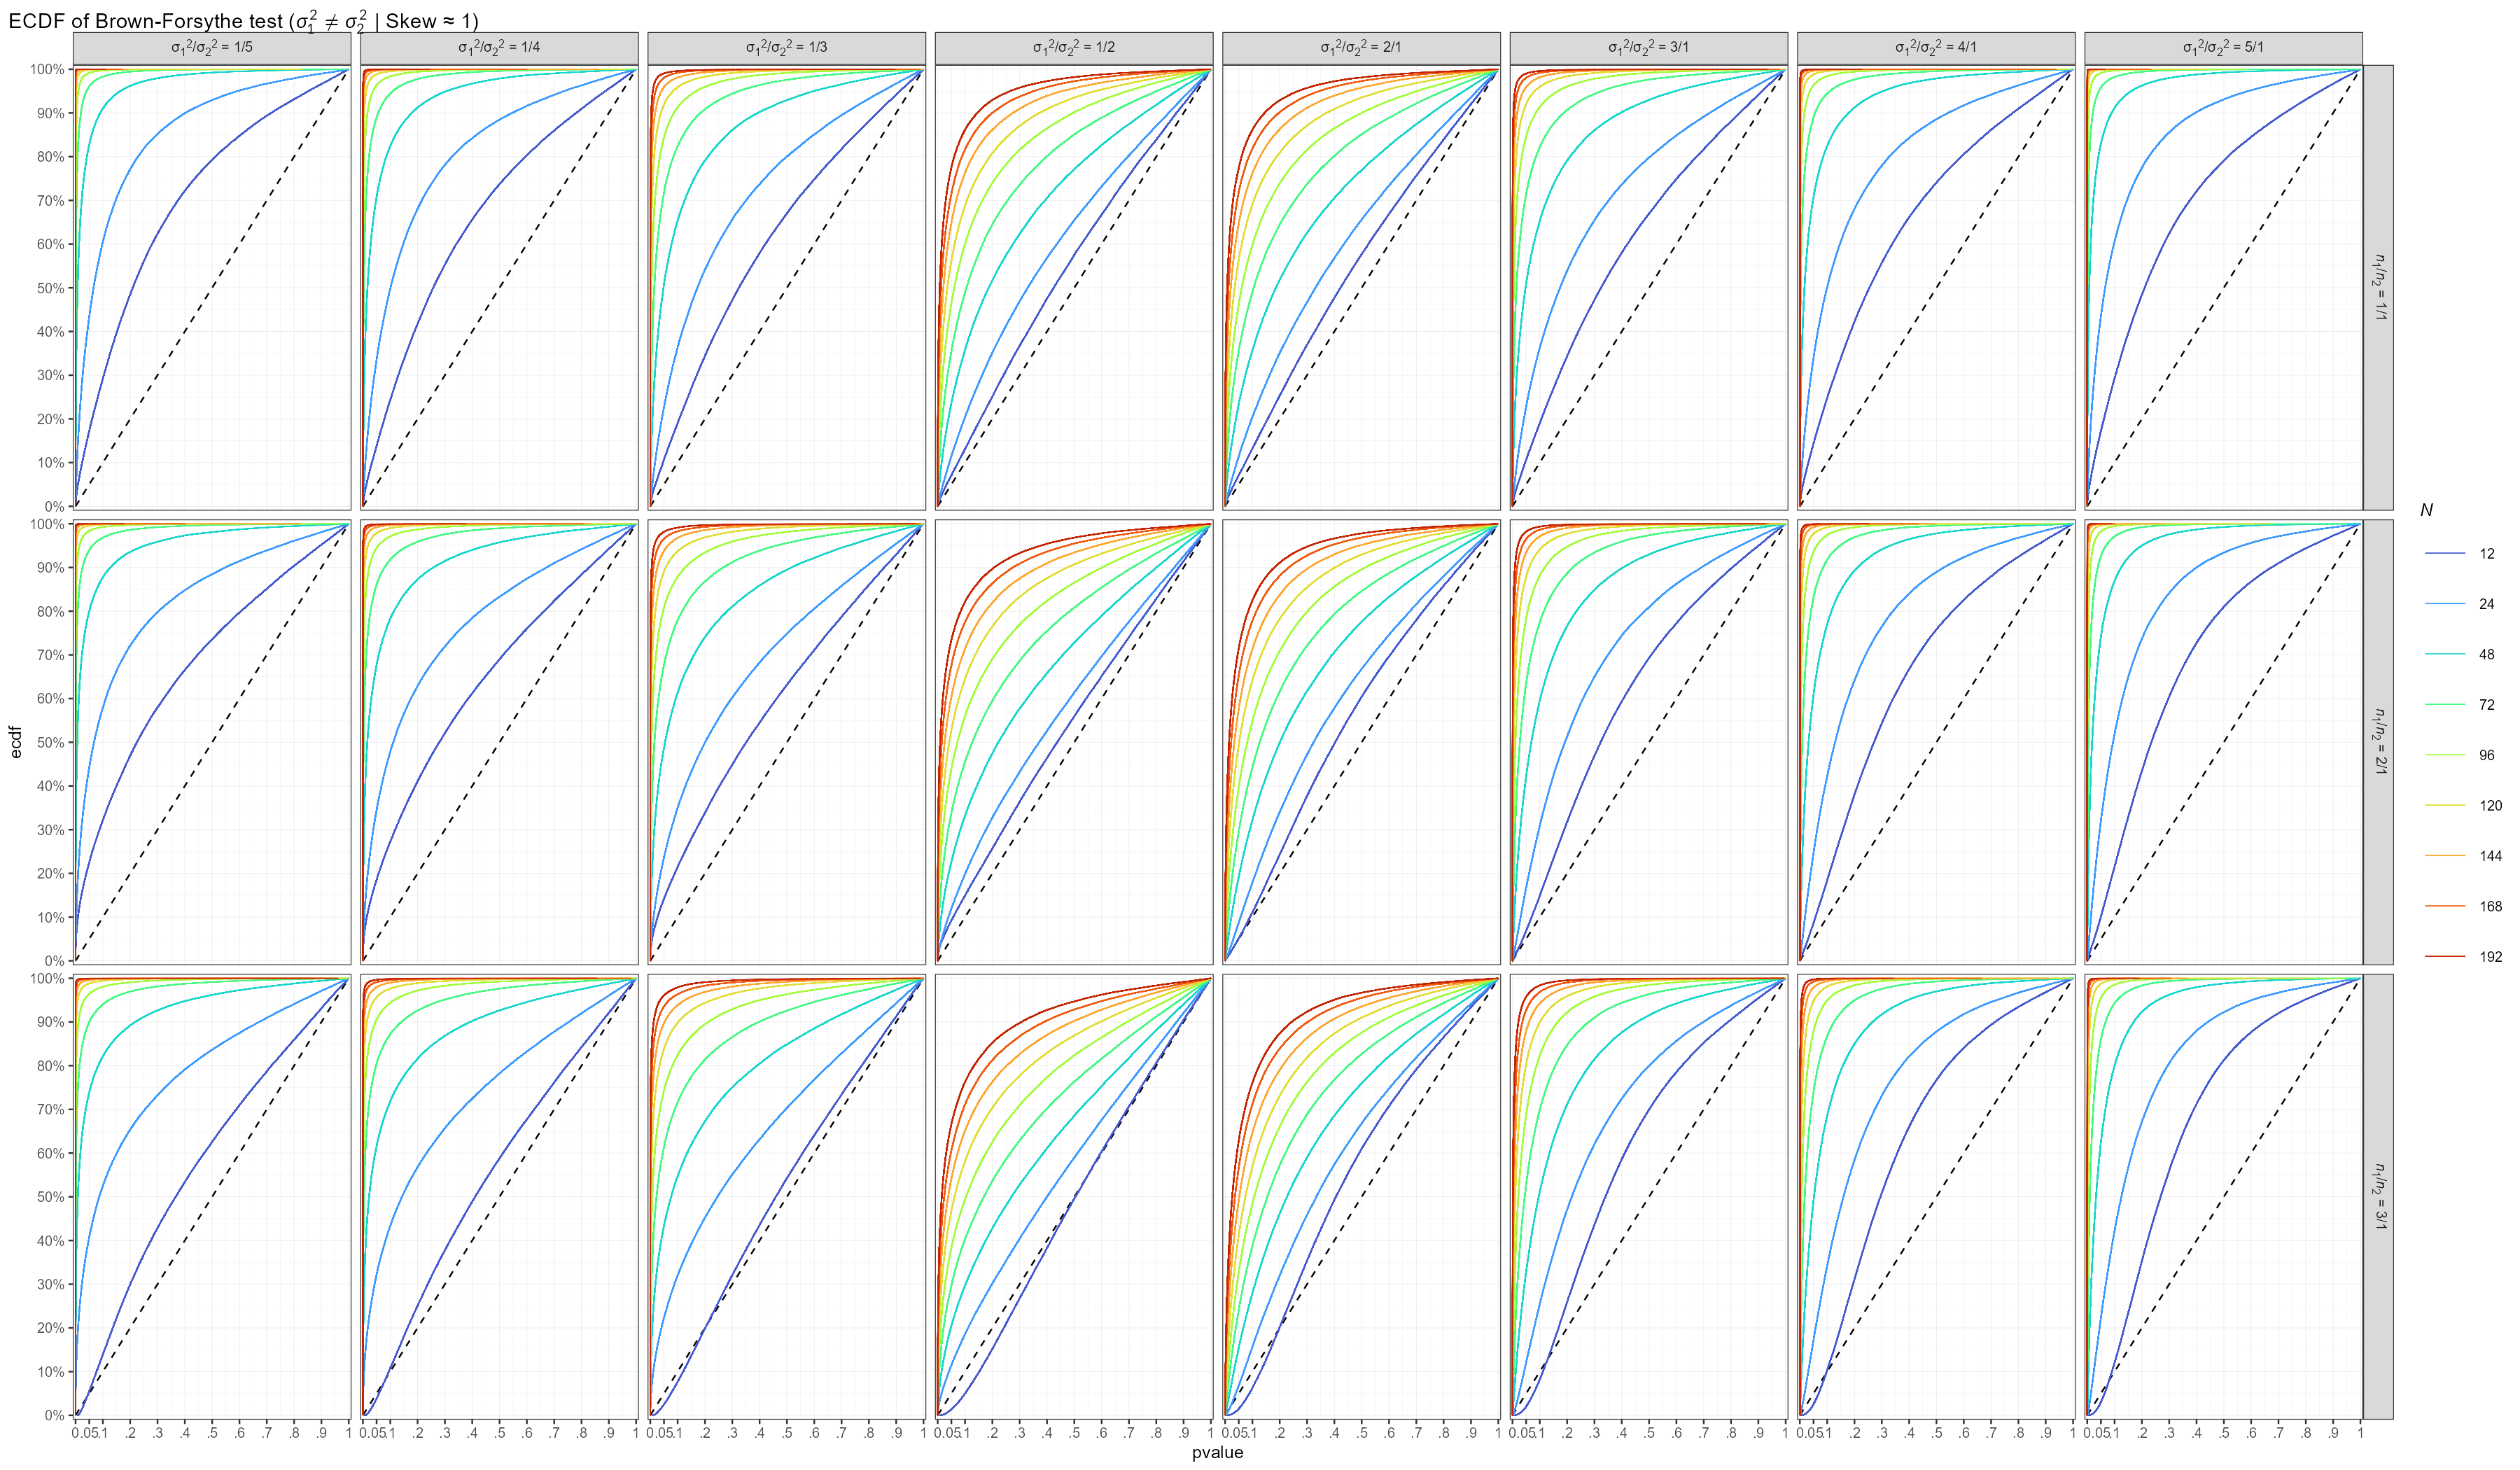
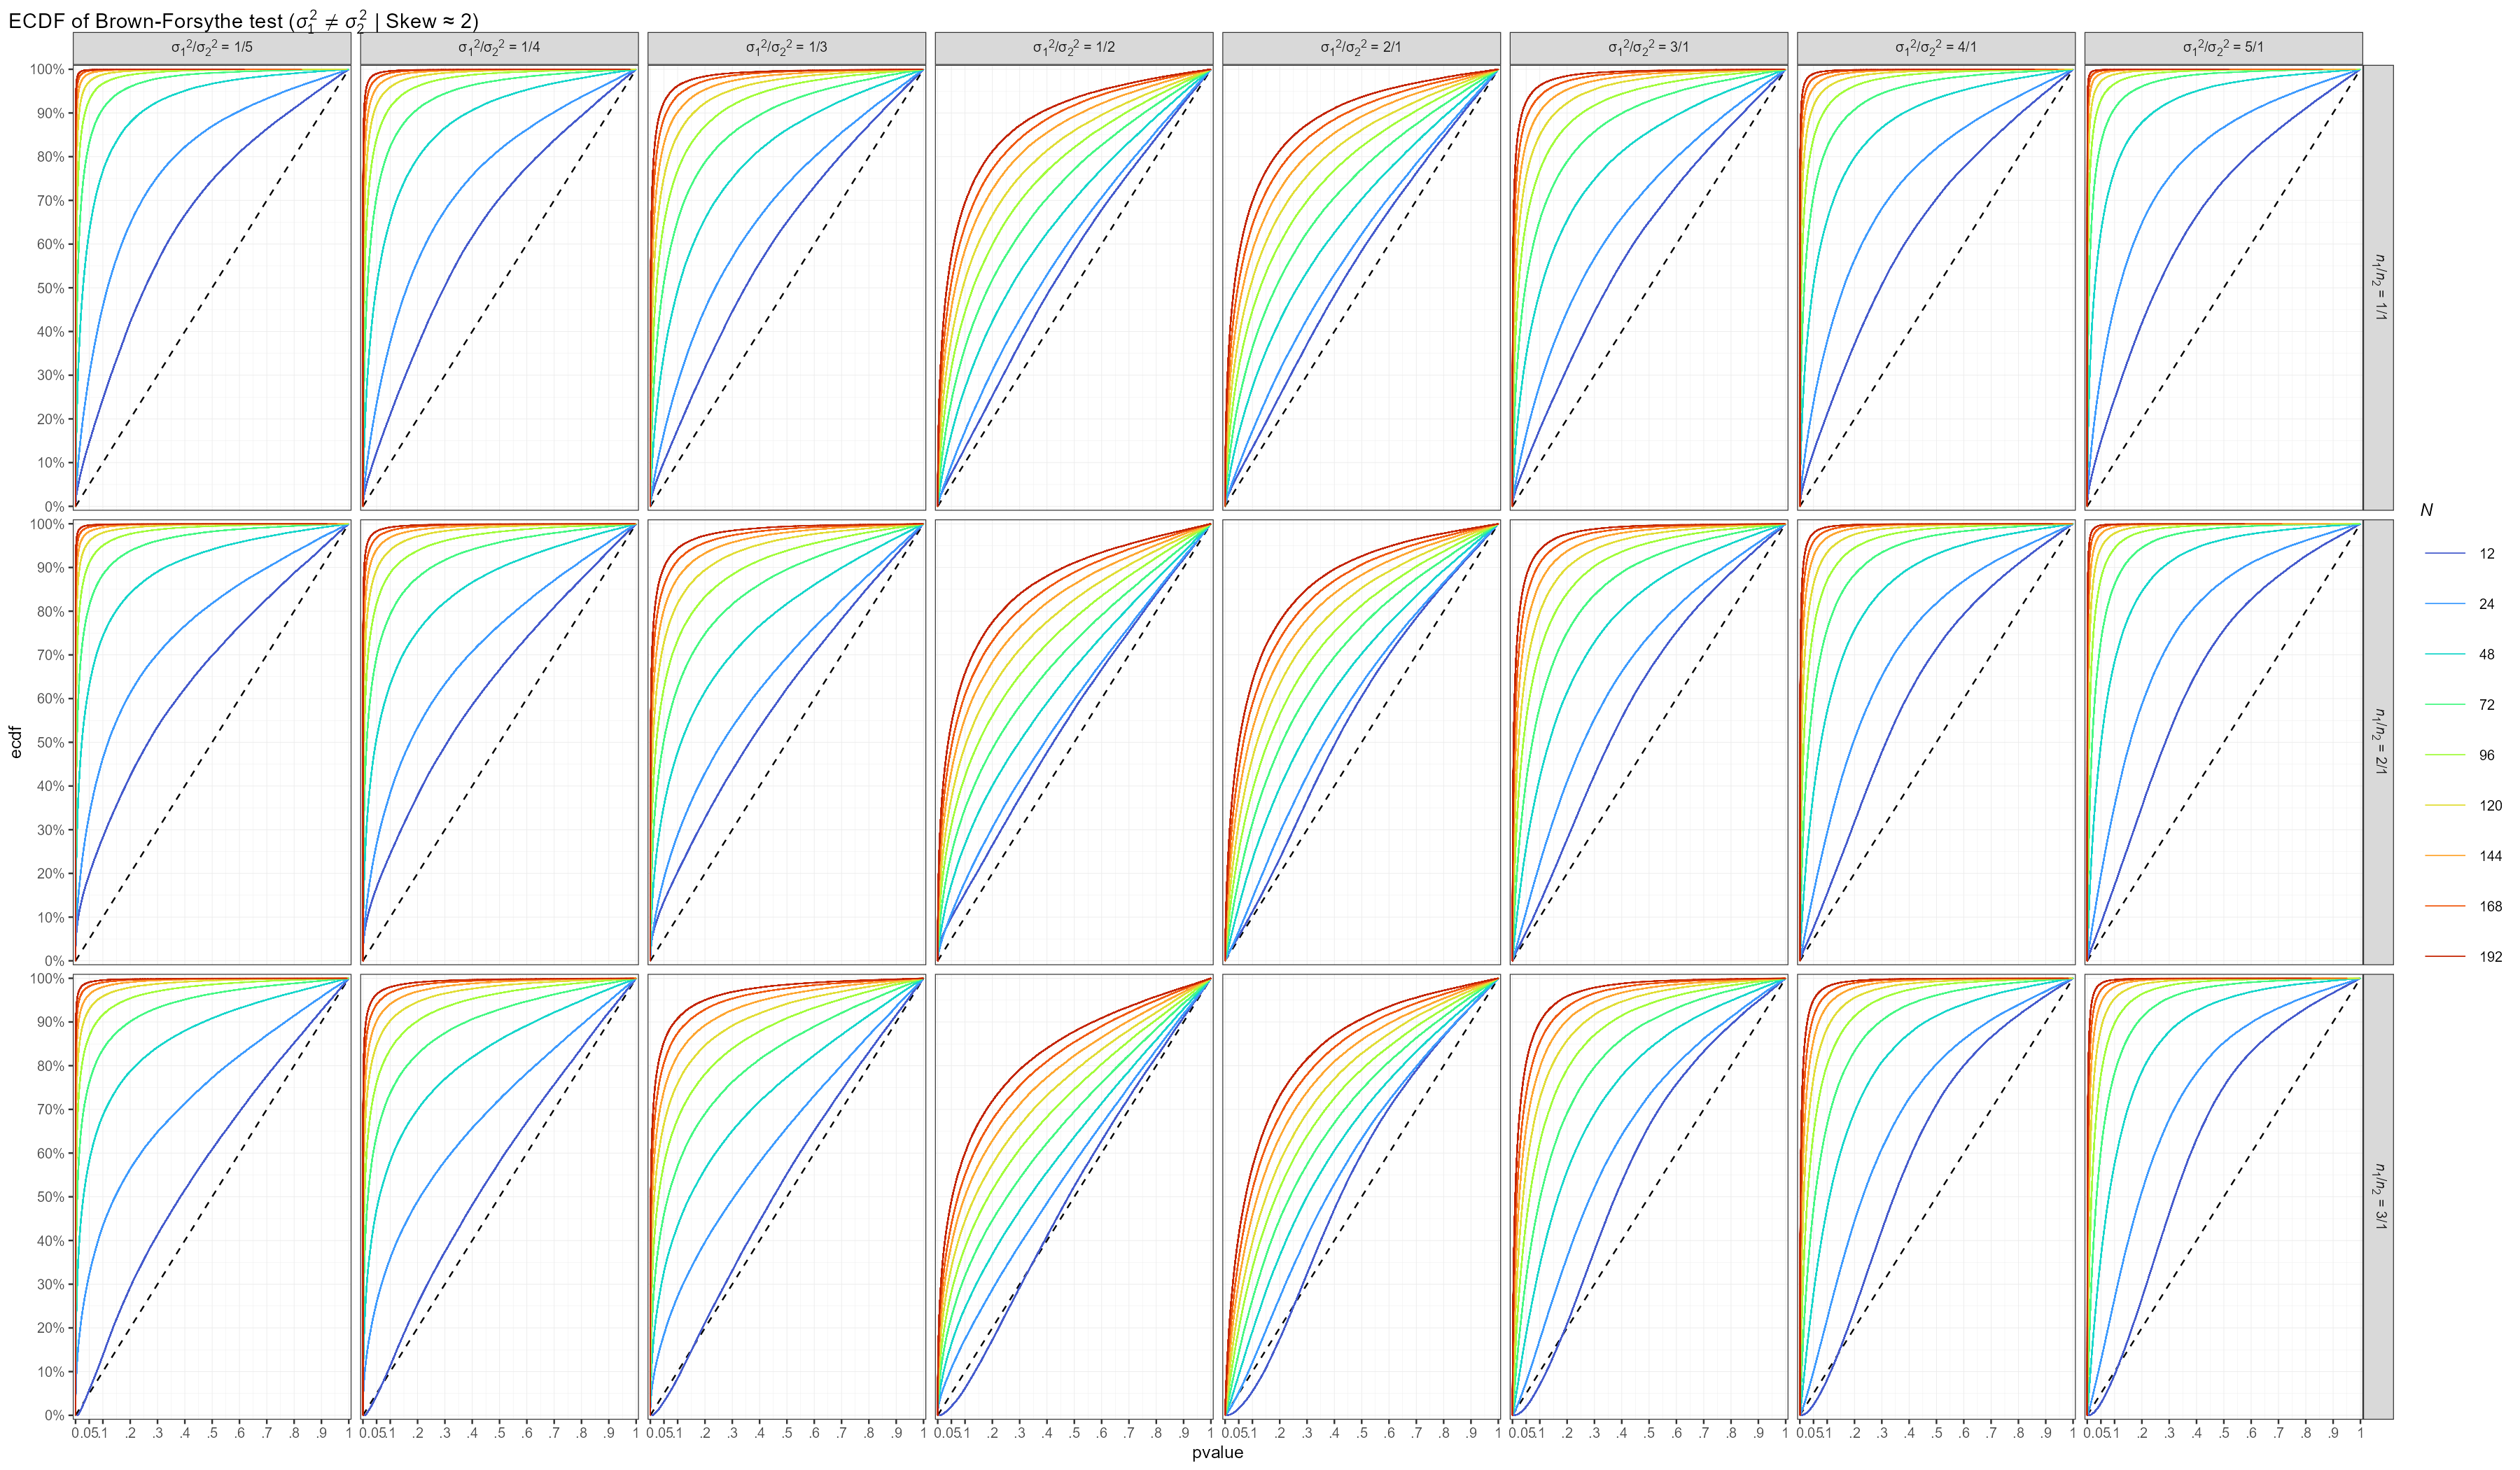
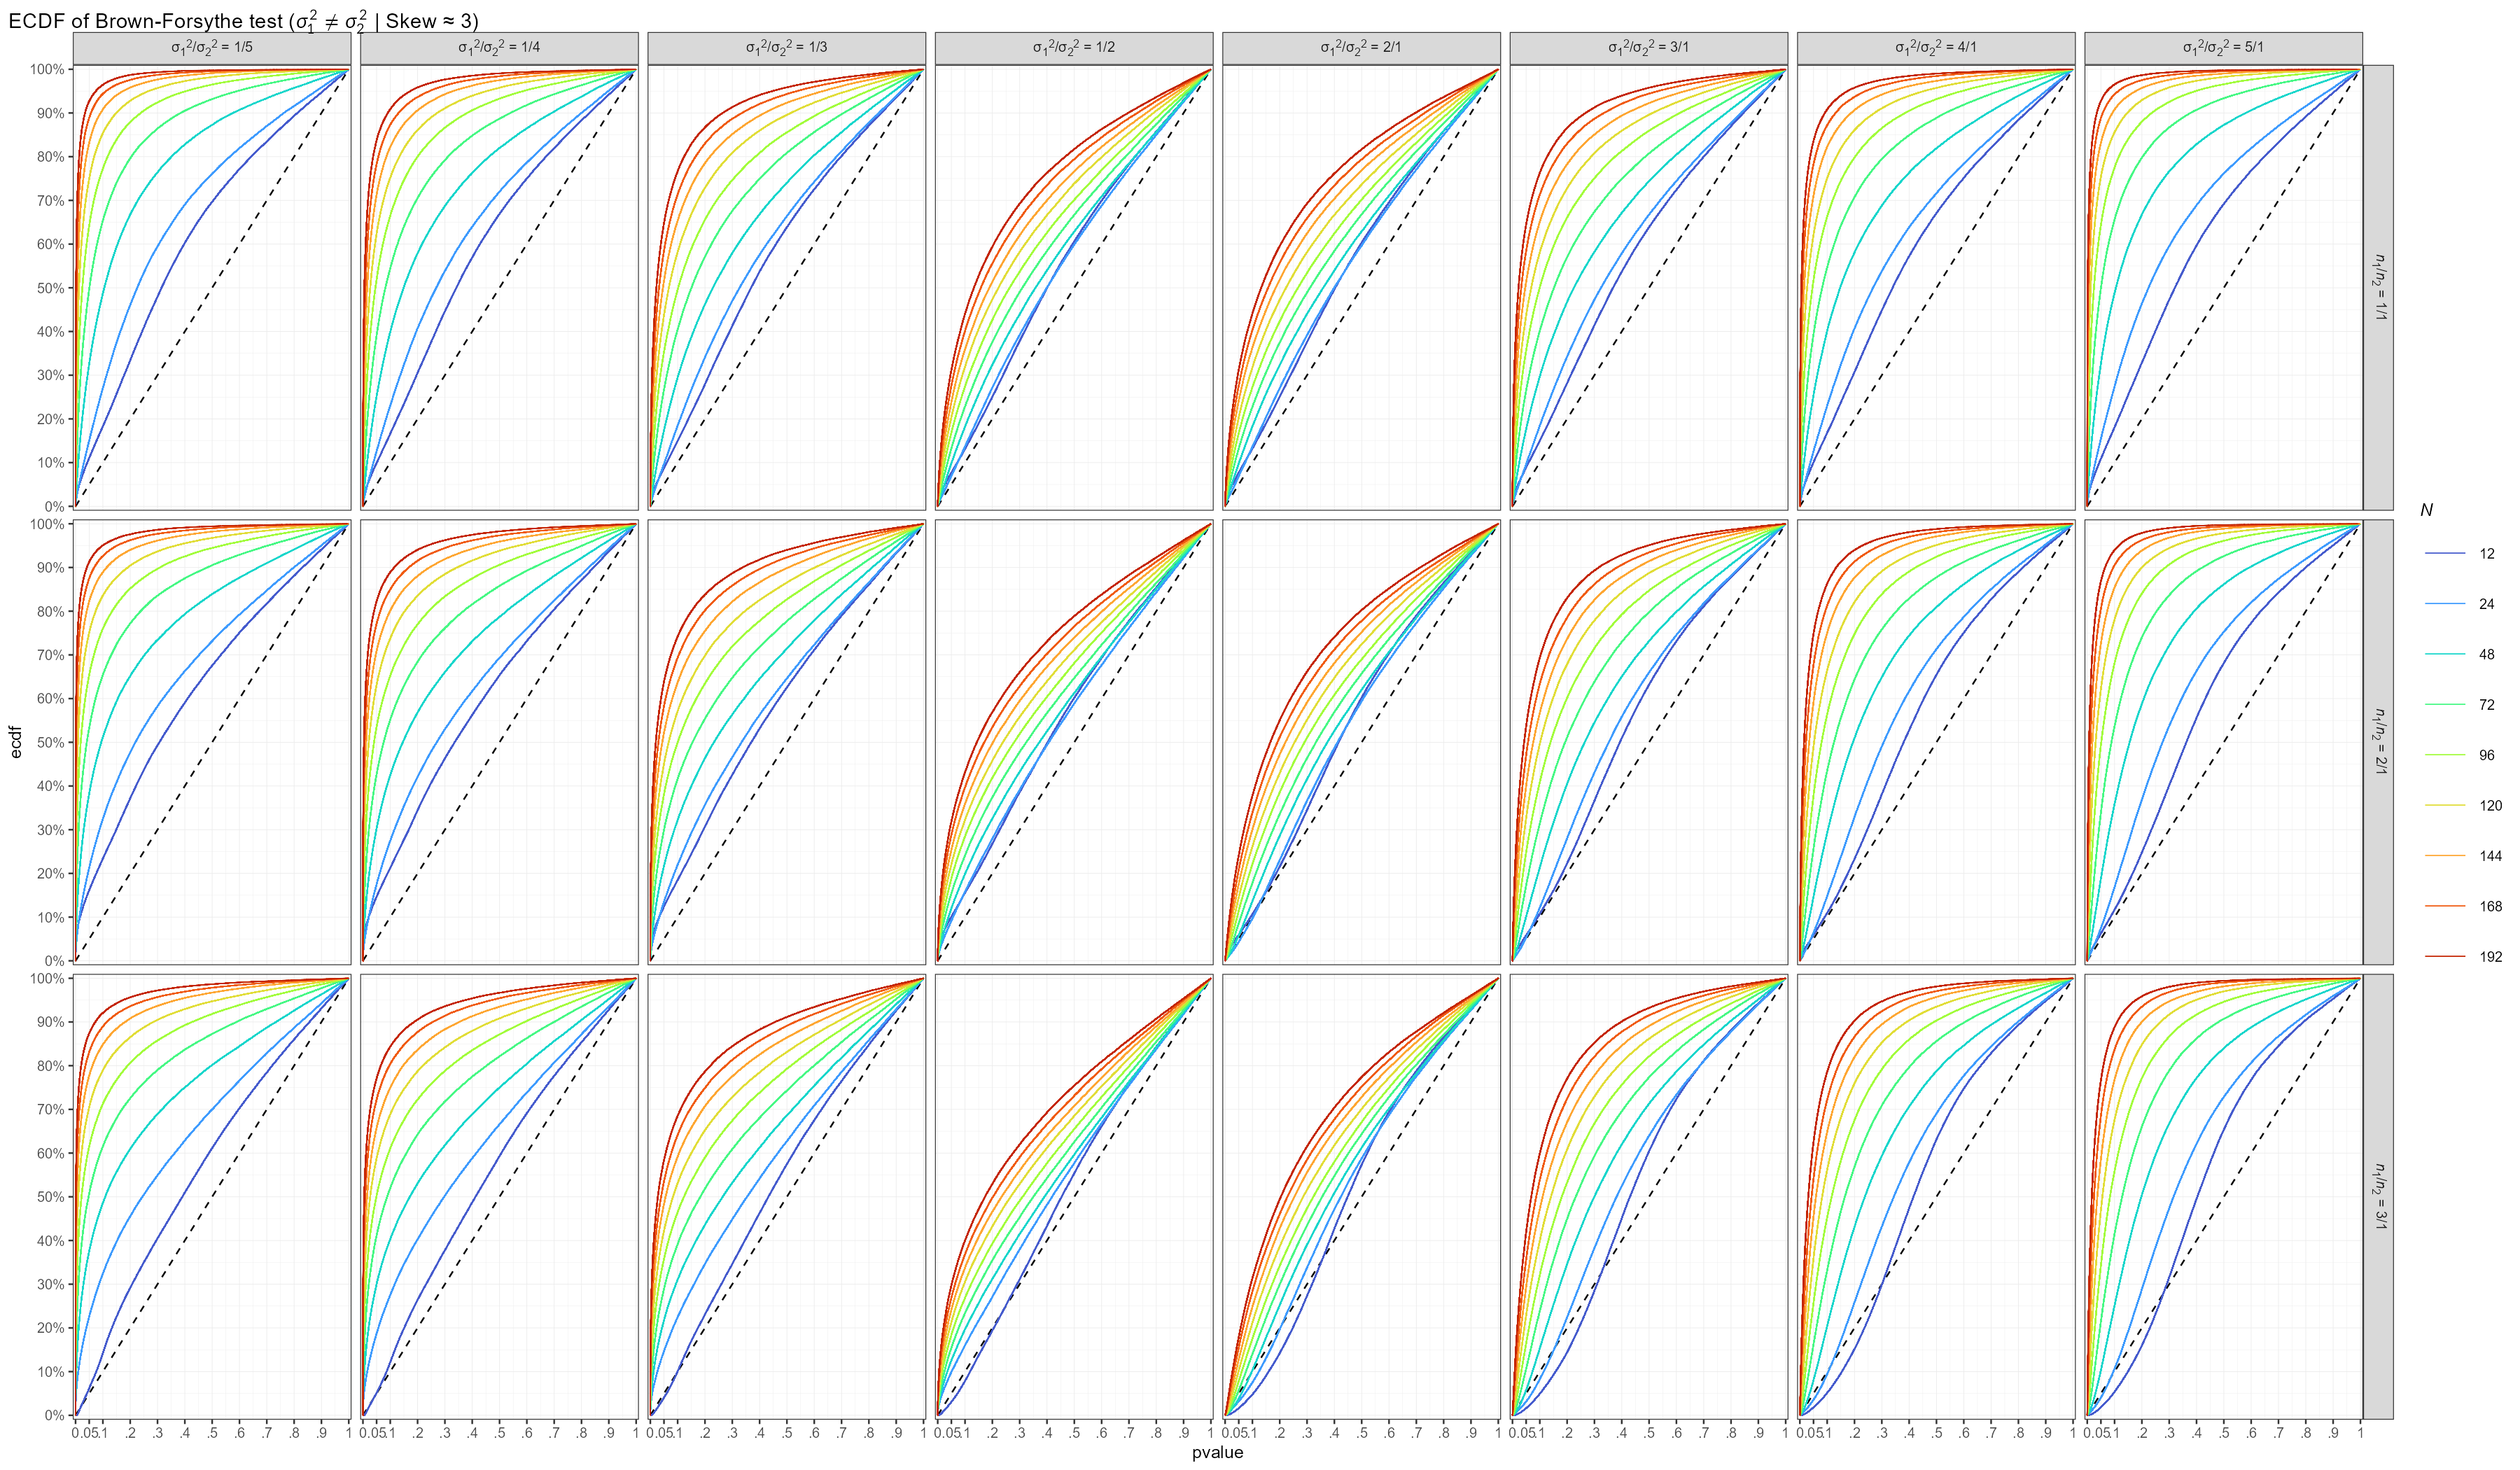
どの歪度でも共通して、母分散比が小さい場合よりも母分散比が大きい場合の方が小さいp値がよく出ていて、また総サンプルサイズが少ない場合よりも多い場合の方が小さいp値がよく出ていた、すなわちそれらの条件の方が同じ有意水準αで経験的検出力が高かったことがわかります。また、各歪度で比べてみると、歪度が大きくなるにつれて小さいp値が出づらくなっていた、すなわち同じ有意水準αで経験的検出力が小さくなっていたことがわかるかと思います。そして、特筆すべきはの\(N=12\)でしょうか。この条件だけカーブがS字っぽい(特に\(:\sigma_1^2 \gt \sigma_2^2\)で\(n_1/n_2=3/1\)のとき)です。もしかすると少ない総サンプルサイズでもっと歪度を大きくするともっと面白いECDFになるかもしれません。(というか\(Skew \approx 3\)のときは\(N=24\)の線もか?)
Conclusion
今回は Nordstokke & Zumbo (2007) の等分散性の検定のシミュレーションをRで再現+αしてみました。表の数値についてはF検定がかなり元論文と乖離してしまいましたが、元論文の主旨、つまり、Levene検定とF検定のType I error rateは分布の歪度と群間のサンプルサイズ比に影響を受けるという点、両検定が名目上のαを維持できる条件(歪度≈0)ではF検定の方が検出力が高いという点、は再現・確認できたと思います。また+αとして、元論文ではシミュレーションされていなかったBrown-Forsythe検定とnp- Levene検定を追加しましたが、前者のエラー率については総サンプルサイズがかなり少ないときの挙動が怪しいが基本的には問題なさそうだということ、後者に関してはいろいろと問題ありということが確認できました。
今回の結果を踏まえると、Type I error の観点から、少なくとも母集団分布が左右対称ではなさそうなときに、等分散性の検定としてLevene検定(とF検定)を使うのはあまり勧められず、Brown-Forsythe検定を用いるのがいいのかなと思うところです。対称な分布であればLevene検定でもいいんですが、その条件ならF検定の方が検出力が高いのでF検定を使った方がいいし、結局のところ母集団分布が左右対称かどうかは神のみぞ知る案件で実際のころ我々にはわからないので、等分散性の検定をしたいのであればLevene検定よりもBrown-Forsythe検定を使うことをお勧めする、ということになりそうです。
ただ、BF検定もサンプルサイズがかなり小さいときの挙動が怪しかったので、その条件をもっと見てみる必要があるかもです。 それと、左右対称な分布で尖度が異なる条件は試していないので、よさげな分布を使って確認する必要はありますね。 Brown & Forsythe (1974) はデータ生成にt分布(と、あとベンチマーク的な感じでコーシー分布)を使っていたので、それの再現もいつかやってみようかと思います。また、途中で紹介した Shear et al. (2018) のように平均値差も考慮してシミュレーションを回すのも必要ですね。 Shear et al. (2018) には分散を考えるなら局外パラメータとして平均値についても考えた方がいいと書いてありましたし、そもそも等分散性の検定のシミュレーションを回しているのは、2段階t検定がなぜよくないかのシミュレーションの前哨戦のつもりだったので。
シミュレーションについては、やはりp値をそのまま保存してECDFを作る方のはいいですね。条件が多いとファセットを使ってもプロットを出力枚数が増える点と、反復回数が多いと描画に時間がかかる点が大変ですが…。結果の分かりやすい可視化についても、まだまだ勉強が必要です。
Session Information
NoteSession Information
R version 4.5.3 (2026-03-11 ucrt)
Platform: x86_64-w64-mingw32/x64
Running under: Windows 11 x64 (build 26100)

Matrix products: default
  LAPACK version 3.12.1

locale:
[1] LC_COLLATE=Japanese_Japan.utf8  LC_CTYPE=Japanese_Japan.utf8    LC_MONETARY=Japanese_Japan.utf8
[4] LC_NUMERIC=C                    LC_TIME=Japanese_Japan.utf8

time zone: Asia/Tokyo
tzcode source: internal

attached base packages:
[1] stats     graphics  grDevices utils     datasets  methods   base

other attached packages:
 [1] furrr_0.4.0         future_1.75.0       matrixTests_0.2.3.1 Rfast_2.1.5.2
 [5] RcppParallel_6.2.1  zigg_0.0.2          Rcpp_1.1.2          lubridate_1.9.5
 [9] forcats_1.0.1       stringr_1.6.0       dplyr_1.2.1         purrr_1.2.2
[13] readr_2.2.0         tidyr_1.3.2         tibble_3.3.1        ggplot2_4.0.3
[17] tidyverse_2.0.0

loaded via a namespace (and not attached):
 [1] tidyselect_1.2.1   farver_2.1.2       S7_0.2.2           fastmap_1.2.0      duckdb_1.5.5
 [6] pacman_0.5.1       digest_0.6.39      timechange_0.4.0   lifecycle_1.0.5    duckplyr_1.2.1
[11] magrittr_2.0.5     compiler_4.5.3     rlang_1.3.0        sass_0.4.10        tools_4.5.3
[16] gridmicrotex_0.1.1 utf8_1.2.6         yaml_2.3.12        gt_1.3.0           knitr_1.51
[21] simhelpers_0.3.1   collections_0.3.12 labeling_0.4.3     htmlwidgets_1.6.4  bench_1.1.4
[26] xml2_1.6.0         RColorBrewer_1.1-3 withr_3.0.3        grid_4.5.3         e1071_1.7-17
[31] globals_0.19.1     scales_1.4.0       cli_3.6.6          rmarkdown_2.31     ragg_1.5.2
[36] generics_0.1.4     otel_0.2.0         rstudioapi_0.19.0  tzdb_0.5.0         commonmark_2.0.0
[41] DBI_1.3.0          cachem_1.1.0       proxy_0.4-29       parallel_4.5.3     matrixStats_1.5.0
[46] base64enc_0.1-6    vctrs_0.7.3        jsonlite_2.0.0     litedown_0.11      hms_1.1.4
[51] patchwork_1.3.2    listenv_1.0.0      systemfonts_1.3.2  glue_1.8.1         parallelly_1.48.0
[56] codetools_0.2-20   ggtext_0.2.0       stringi_1.8.9      gtable_0.3.6       pillar_1.11.1
[61] htmltools_0.5.9    R6_2.6.1           textshaping_1.0.5  Rdpack_2.6.6       evaluate_1.0.5
[66] markdown_2.0       rbibutils_2.4.1    gridtext_0.1.6     memoise_2.0.1      class_7.3-24
[71] xfun_0.60          fs_2.1.0           pkgconfig_2.0.3
References
Brown, M. B., & Forsythe, A. B. (1974). Robust Tests for the Equality of Variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.2307/2285659
Nordstokke, D. W., & Zumbo, B. D. (2007). A Cautionary Tale about Levene’s Tests for Equal Variances. Journal of Educational Research & Policy Studies, 7(1), 1–14.
Shear, B. R., Nordstokke, D. W., & Zumbo, B. D. (2018). A Note on Using the Nonparametric Levene Test When Population Means Are Unequal. Practical Assessment, Research, and Evaluation, 23(1). https://doi.org/10.7275/bwvg-d091
Footnotes
https://tsakai-website.pages.dev/posts/20260826_rep_delacre_etal_2017_fig1/↩︎
私は原典にあたれていないのですが、Nordstokke & Zumbo (2007) も Brown & Forsythe (1974) も Levene (1960) Robust tests for equality of variances. を引用文献に挙げています。↩︎
ちなみに、最新版であるIBM SPSS Statistics 32のt検定のセクションにある等分散性の検定を見てきましたが、絶対値の中身が各群の個々の観測値-群の平均値なので、やはり使われているのはオリジナルのLevene検定ですね。
参考: https://www.ibm.com/docs/SSLVMB_32.0.0/pdf/IBM_SPSS_Statistics_Algorithms.pdf↩︎https://philchalmers.github.io/SimDesign/html/Nordstokke_Zumbo2007.html↩︎
bench::mark()でベンチマークをとったところ、rchisq(1e5L, df = 0.83)が中央値12.7ms、rchisq(1e5L, df = 1e4L)が中央値4.91msでした。要素が10万もあると微妙に時間がかかりますね。↩︎https://ja.wikipedia.org/wiki/%E3%82%AB%E3%82%A4%E4%BA%8C%E4%B9%97%E5%88%86%E5%B8%83↩︎
parquet形式での保存には
arrow::write_parquet()を使いました。あとでduckplyr::compute_parqret()でもできることを知りました。parquetは初めて使うので、念のためreadr::write_rds(..., compress = "gz)もやっておいたんですが、それでも2.5GBでした。あと、qs2::qs_save()も試したけど、rdsファイルとそこまで変わらずだった気がします(消しちゃって覚えてない)。↩︎シミュレーションの精度は \(\sqrt{100000/5000}\) で4倍程度こちらの方が高いはずですが、さすがに10%程度異なってくると何かの間違いを疑いたくなります。もしどなたか気づいたら教えてください。↩︎
ERRが上回っているかどうかはもうちょっとちゃんと考える必要があると思います。一応95%(99%)MCCIが被っていないかとか。棄却率のシミュレーションであれば、ERR=50%のときにMCSEが最悪(最大)になり、 \(\sqrt{.5^2/100000}\approx0.0015\) です。正規近似を使って95%MCCIを構成すると \(\hat{p}\pm1.96\times0.0015\approx\hat{p}\pm0.003\) となるので、大きく見積もって0.5%くらい差がついていれば、ERRに差があると判断してもよさそうなのかな、といったところです。↩︎